Hola, Planet Debian. Mi blog acaba de entrar en Planet Debian y en Planet Debian en español, así que lo educado es presentarme antes de que empecéis a encontraros mis entradas entre las vuestras.
Soy Juan Manuel Méndez Rey, de Sevilla. En Debian soy mendezr, y en OFTC soy Vejeta. Uso Linux desde 1994 y Debian desde 1998. Durante mucho tiempo eso fue todo: un usuario feliz que instalaba, rompía cosas y leía las listas de correo desde fuera. Empecé a contribuir en octubre de 2025, y el mes pasado me convertí en Debian Maintainer.
Un amigo y un RFP antiguo
La puerta de entrada fue un amigo. En 2019 Arturo Borrero González abrió el RFP #943703 para Stremio, y durante años me estuvo diciendo que debería cogerlo yo. En septiembre de 2025 por fin le hice caso y lo convertí en un ITP. Tardé más de lo que me gusta admitir, pero Stremio ya está en Debian, y aquí conté esa historia. Un RFP de seis años resultó ser un primer paquete estupendo.
Rescatar software antiguo
Por el camino descubrí que lo que más disfruto es devolverle la vida al software antiguo.
El primero vino de tille, que pidió ayuda en #debian-tinytasks con xwpe, un editor de programación para la terminal al estilo de Borland del que nadie se ocupaba. Lo adopté, y acabé siendo también su mantenedor upstream. Arreglé los fallos antiguos y le añadí LSP y DAP, así que ahora un editor de 1993 puede depurar Go. Está en varias distribuciones, en Homebrew y en los BSD. El repositorio canónico está en Codeberg, y la versión larga está en esta entrada.
El segundo es más antiguo y me llevó mucho más tiempo. Conquer es un juego de estrategia para Unix que escribieron Ed Barlow y Adam Bryant en 1987, y le dediqué muchas horas de mi juventud. Nunca tuvo una licencia libre. Pregunté por él por primera vez en debian-legal en octubre de 2006, y pasé los 20 años siguientes buscando a sus autores, correo a correo. Hoy Conquer v4 y V5 son GPL-3.0. Todavía no está empaquetado en Debian, ese es el siguiente paso, pero ya puedes jugarlo en el navegador.
En qué ando ahora
CEF me llevó seis meses y me metió en el equipo de Chromium, y estos días estoy sobre todo con las herramientas de seguridad syft, trivy y grype, y con Scala 3 y sbt para Debian.
Gracias
A Arturo, por el empujón. A dilinger, tille y tsimonq2, que avalaron mi solicitud de DM, por su confianza.
Y si puedes patrocinar subidas de syft, trivy, grype o del trabajo de Scala, te lo agradeceré mucho. Los detalles están en mi página de la wiki.
Me puedes encontrar allí, como Vejeta en OFTC, o en Mastodon como @vejeta@mastodon.sdf.org. Encantado de conoceros.
Stremio fue el primer paquete que intenté construir cuando empecé a contribuir en Debian como colaborador habitual. Fue todo un viaje, como saben los que han seguido este blog…
Primero empaqueté el antiguo stremio-qt5 (basado en QT5, que está llegando al final de su vida útil, así que todos los parches que hicieron falta y las semanas peleando para que compilara son ahora una aventura que contar a mis nietos.
Después empaqueté stremio-cef, el paquete basado en Chromium Embedded Framework, que exigía compilar el propio CEF como biblioteca para Debian, un camino que me llevó meses completar y que fue mi introducción a contribuir en el equipo de Debian de Chromium.
A fecha de 24 de septiembre de 2026, Stremio forma parte del propio Debian:
Paquete
Dónde
Qué es
stremio 1.2.0+ds-1
Debian unstable, main
El cliente GTK4 / libadwaita / WebKitGTK 6
stremio-server-installer 1
Debian unstable, contrib
Descarga el componente de servidor de streaming en el momento de la instalación
Por el camino entraron en Debian main diez crates de Rust nuevas como requisitos previos
(webkit6, webkit6-sys, javascriptcore6, javascriptcore6-sys, epoxy, libmpv2, libmpv2-sys, byteorder-lite, piper, discord-rich-presence).
Si estás en unstable/sid, instala Stremio desde Debian, no desde aquí.
Este repositorio distribuía antes un paquete llamado stremio en la versión 4.4.181+dfsg-1, que era el cliente Qt5 antiguo. El paquete de Debian es 1.2.0+ds-1. Como 4.4.181 ordena por encima de 1.2.0, apt trata el paquete de Debian como una regresión y no te cambia por su cuenta. Aquí pasan dos cosas, en dos pasos:
Paso 1 (ahora). El cliente Qt5 se ha renombrado a stremio-qt5, y este repositorio distribuye un pequeño paquete de transición stremio que lo arrastra. No se rompe nada: la aplicación que tenías sigue funcionando, solo que con el nombre stremio-qt5, y apt traslada por su cuenta la marca de “instalado manualmente”, así que apt autoremove no se lo llevará más adelante.
Ten en cuenta que un apt upgrade normal no hará esto: no tiene permitido
instalar paquetes nuevos, así que informa de stremio como retenido. Usa:
sudo apt full-upgrade
(verificado en un chroot limpio de unstable contra los paquetes publicados realmente aquí). Después de ejecutarlo, el paquete de transición stremio que sobra aparece como ya no necesario, y sudo apt autoremove lo elimina.
Paso 2 (anunciado por separado, más adelante). Este repositorio dejará de distribuir por completo el nombre stremio. A partir de entonces, stremio significa el paquete de Debian, y puedes cambiar con:
sudo apt remove stremio # removes only the empty transitional package
sudo apt install stremio stremio-server-installer
stremio-server-installer pide confirmación y después descarga el componente de servidor de streaming de los propios servidores de Stremio, verificando su suma de comprobación.
Sustituye al antiguo paquete stremio-server de este repositorio (que estaba en non-free y distribuía ese componente directamente), y ahora es la pieza que comparten todos los clientes: instala server.js en /usr/share/stremio/, que es de donde lo leen tanto el stremio de Debian como el stremio-qt5 de este repositorio.
Si usas el cliente CEF, actualízalo antes de instalar el stremio de Debian
La versión de stremio-gtk publicada aquí hasta ahora instala tres ficheros que el paquete stremio de Debian también instala:
Con esa versión instalada, dpkg se negaría a desempaquetar el paquete de Debian.
Mientras este repositorio siga sirviendo el nombre stremio no te toparás con eso (apt te da en su lugar el paquete de este repositorio), pero pasa a ser relevante en cuanto vayas a por el de Debian. El nuevo stremio-cef mueve esos ficheros a com.stremio.Stremio.CEF.*, así que sudo apt full-upgrade te lo resuelve como parte del paso de stremio-gtk a stremio-cef.
Verificado en un chroot limpio: después de esa actualización, el stremio de Debian y el cliente CEF se instalan uno al lado del otro, como /usr/bin/stremio y /usr/bin/stremio-cef.
Qué sigue llevando este repositorio
Debian no tiene estos, así que se quedan aquí:
stremio-cef (antes stremio-gtk): el cliente basado en CEF. Renombrado porque el propio cliente de Debian también es GTK4, así que “-gtk” ya no distinguía nada; la diferencia real es el renderizador. Un paquete de transición stremio-gtk traslada las instalaciones existentes.
stremio-qt5: el cliente Qt5, publicado antes aquí como stremio
librust-cef-dev, librust-cef-dll-sys-dev: bindings de Rust para CEF
Recomendado: fijar este repositorio por debajo de Debian
Ahora que los paquetes oficiales vienen de Debian, merece la pena decirle a apt que prefiera Debian para todo lo que exista en los dos. Crea /etc/apt/preferences.d/99-vejeta:
Con prioridad 100 (por debajo del 500 por defecto), los paquetes de aquí solo se usan cuando Debian no los proporciona, que es justo para lo que sirve este repositorio a partir de ahora.
Debian stable y testing
El stremio de Debian está en unstable y migrará a testing de la forma habitual, y con el tiempo irá llegando a Ubuntu y a otros derivados de Debian. Los usuarios de bookworm y trixie todavía no están afectados y pueden seguir usando este repositorio como antes.
En los 90, cuando debería haber estado terminando la carrera, jugaba
al Unix Conquer en AIX, discutía en Usenet, merodeaba por IRC y
aprendía cómo funcionaban de verdad los sistemas. No conseguí el título, pero conseguí algo que la carrera no podía enseñar: el instinto de cómo debe sentirse el software UNIX.
Tres décadas después, ese instinto es lo que mueve este rescate. Soy
colaborador de Debian camino de convertirme en Debian Developer: todavía no lo soy, aún necesito patrocinadores para mis subidas. xwpe es uno de mis proyectos fuente adoptados y mi camino de entrada en la comunidad Debian.
Rescatar un editor de 1993 que nadie más quería tocar es justo el tipo de cosa que pasa cuando alguien que creció en la cultura de terminal de los 90 por fin tiene las herramientas y el tiempo para devolver algo.
El nombre en clave
La serie 1.6.x es lo que yo llamaba en mi cabeza «xwpe 2026», y es el ciclo de publicación que trajo al presente 33 años de código dormido. No es una reescritura; es una restauración. Archivamos la documentación dispersa que la web primitiva estaba perdiendo, escribimos el manual que el proyecto siempre necesitó
pero nunca tuvo (en texinfo), y arreglamos cada capa de la pila de renderizado e integración con el compilador para que un usuario de 2026 pueda abrir incluso un fichero .pas (Pascal) o .f90 (Fortran), pulsar F9 y navegar por los errores exactamente como Fred Kruse pretendió en 1993, pero esta vez con UTF-8 en un terminal moderno.
El fósil
xwpe es un entorno de programación al estilo Borland para UNIX, escrito por Fred Kruse en 1993. Dennis Payne lo mantuvo de 2000 a 2006, y después silencio. Toda la gente que contribuyó a él probablemente se pasó a otros IDEs… y Debian lo siguió distribuyendo durante 20 años como un paquete huérfano de hecho: compilaba, así que nadie miró más de cerca. Los usuarios curiosos abrían informes de fallo (algunos estuvieron abiertos 22 años)
En mayo de 2026, GCC 15 rompió la compilación (#1098180). Andreas Tille pidió ayuda en el canal de IRC #debian-tiny-tasks. Ahí entré yo… recordaba xwpe de mis años de universidad y esta podía ser mi primera intervención para rescatar un paquete, y no solo para empaquetar nuevos.
Arqueología digital
Restaurar xwpe se parece a la arqueología de software, y empecé a querer ese título cuando hice algo parecido con conquer, el juego clásico de Unix de los 80 de Ed Barlow y Adam Bryant. Después de que alguien dejara un comentario en esa dirección en Hacker News, y como me gustaba que se me considerara así, lo adopté sin más.
Con la arqueología de software apartas capas de polvo y encuentras código que fue sólido para su época: un analizador de errores del compilador basado en patrones,
un sistema de renderizado con doble búfer manual, guardado y restauración de ventanas emergentes superpuestas. Todo diseñado en 1993, cuando ncurses era joven y los terminales eran lentos.
Pero se habían instalado 30 años de podredumbre acumulada:
La migración a SCREENCELL (v1.6.0) cambió las celdas de pantalla de 2 bytes a 8 bytes por el UTF-8. El sistema de guardado y restauración de ventanas emergentes nunca se adaptó del todo: datos del montón sin inicializar se propagaban por los ciclos de guardado y restauración, produciendo caracteres CJK y artefactos en pantalla al cerrar los menús. valgrind mostró 15,857 errores de valor sin inicializar.
El analizador de errores del compilador esperaba el entrecomillado con acentos graves del GCC de los años 90 `ret'), pero el GCC moderno usa comillas simples ('ret'). El patrón gnu_intstr no se había actualizado en décadas. La navegación por errores (Alt-T/Alt-V) estaba rota en silencio. Lo actualizamos al formato estándar file:line:column: que GCC usa desde la 4.8 (2013).
print_to_end_of_buffer se paraba en la primera línea en blanco con un break. Eso significaba que cualquier compilador que emite líneas en blanco entre errores (gfortran, clang con diagnósticos de caret) solo mostraba el primer error en la ventana Messages. Un fallo de una sola línea con más de 20 años de edad.
Nombres de compilador por defecto: f77 para Fortran, pc para Pascal. Nadie los había actualizado desde los años 90. Los actualizamos a gfortran (con .f90/.f95/.f03/.f08), fpc (con .pas/.pp y un patrón dedicado ${FILE}(${LINE},${COLUMN})*), y añadimos javac como quinto compilador por defecto.
Flags -c -o escritos a fuego: e_comp() pasaba los -c y -o propios de gcc a todos los compiladores. Free Pascal y javac se atragantaban con -c. Hicimos que los flags dependieran del estilo de compilador: los compiladores GNU los reciben, los que no son GNU no.
Código de salida del compilador ignorado: ret = 0 estaba escrito a fuego después de wait() desde la época de Payne. xwpe nunca sabía cuándo fallaba la compilación. Arreglado con WIFEXITED/WEXITSTATUS.
Probamos cada compilador de forma interactiva: escribir un programa con
errores deliberados en dos funciones separadas, pulsar F9, comprobar que los errores
aparecen en Messages, pulsar Alt-T/Alt-V para navegar entre ellos, verificar que el cursor salta a la línea y columna correctas. gcc, g++, gfortran, fpc y javac pasaron todos. El motor de coincidencia de patrones de Kruse de 1993 (${FILE}, ${LINE}, ${COLUMN}, comodines) los manejó todos y solo tuvimos que actualizar los patrones por defecto y enseñar a e_comp() que no todos los compiladores son gcc.
Cada arreglo revela la capa siguiente. Arreglas el búfer SCREENCELL y por fin puedes ver los errores del compilador. Arreglas la visualización de errores y descubres que la navegación por errores está rota. Arreglas el patrón y encuentras que el búfer de salida se estaba truncando. Arreglas el truncamiento y descubres que los valores por defecto del compilador son de 1993.
Despertando al depurador
La capa más profunda era el depurador. xwpe habla con gdb a través de tuberías: hace fork de un hijo, lanza gdb y se comunica escribiendo comandos y leyendo respuestas. Esta es la función que convirtió a xwpe en un IDE, no solo en un editor. Y llevaba años muerta.
Tres fallos, apilados como estratos geológicos:
Estrato 1: canibalismo SIGCHLD. El manejador de señal para la muerte de procesos
hijos usaba wait(), que recolecta cualquier hijo. Cuando xwpe
llamaba a popen("tty") para saber el nombre de su terminal, el pequeño subproceso tty
terminaba, disparaba SIGCHLD y wait() se lo comía.
Después pclose() llamaba a waitpid() por un proceso que ya
no estaba. Bloqueo. El arreglo: waitpid(-1, &statloc, WNOHANG): sin bloqueo, recolecta solo lo que esté listo.
Estrato 2: compilación fantasma. Cuando el fichero .o ya
estaba al día, xwpe se saltaba el compilador pero aun así llamaba a la función
que espera la salida del compilador. wait() sin ningún proceso hijo falla
al instante, y xwpe concluía que la compilación había fallado. El
depurador nunca llegaba a arrancar.
Estrato 3: enlazado fantasma. El mismo fallo, una función más arriba. El
ejecutable estaba al día, se saltaba el enlazado, pero el código de espera del
enlazador seguía ejecutándose y «fallaba».
Cada estrato tapaba el de abajo. No podías ver el fallo de SIGCHLD hasta que se arreglaban las compilaciones fantasma. No podías ver esas hasta que se arreglaba el renderizado SCREENCELL. No podías arreglar el renderizado hasta que el UTF-8 funcionaba.
Después de los tres arreglos: Ctrl-G B pone un punto de interrupción. Ctrl-G R arranca gdb. F8 recorre el código paso a paso. Las variables se actualizan en la ventana Watch. Ahí fue cuando me cayó encima la sensación de dicha, al ver los puntos de interrupción y los colores de la línea moviéndose sobre cada línea.
La pila de llamadas muestra la cadena de funciones. Funciona exactamente como Borland Turbo Debugger, que es justo lo que Fred Kruse estaba construyendo en 1993.
El problema de la pantalla de usuario
Pero ¿a dónde va la salida de printf? En el IDE DOS de Borland, el programa tenía su propia página de vídeo: cambiar era un vuelco de registro de hardware, instantáneo. En los terminales UNIX, Kruse usaba smcup/rmcup (búfer de pantalla alternativa) para cambiar entre el editor y la salida del programa.
Cada paso de F8: rmcup, gdb ejecuta una línea, smcup de vuelta. En un VT220 de 1993 por serie, esto era invisible. En un emulador de terminal de 2026 por SSH, es un parpadeo que distrae.
La solución de XWPE 1.5 era desactivar por completo la pantalla de usuario bajo ncurses con una guarda #ifndef NCURSES rota que hacía que Ctrl-G P siempre devolviera un error. Problema escondido, no resuelto.
Nuestro enfoque: eliminar por completo el cambio de pantalla. Usar un
pseudoterminal (pty) para capturar la salida del programa en memoria. El programa escribe a un esclavo pty (que parece un terminal real: isatty() devuelve true, stdout tiene búfer por líneas). xwpe lee del maestro pty a un búfer. Ctrl-G P muestra el búfer. Sin smcup/rmcup durante los pasos, cero parpadeo.
Pero hay una trampa con la que tropieza todo desarrollador de IDEs: glibc almacena en búfer
stdout incluso cuando está conectado a un pty, porque el pty lo abre gdb (no se hereda como fd 1). La salida se queda en un búfer de espacio de usuario dentro del proceso depurado y nunca llega al pty hasta que el programa termina o llama a fflush(). La solución, compartida por gdbgui, Eclipse CDT y VS Code cpptools:
después de cada paso, enviar call (void)fflush(0) a gdb. Esto fuerza el vaciado del búfer de stdout del proceso depurado, y la salida llega al maestro pty donde xwpe puede leerla.
El mismo patrón se aplica a la integración con jdb (Java Debugger). El
arranque de la VM de jdb es asíncrono: envías run y el prompt vuelve al instante, pero el punto de interrupción salta segundos después, cuando la JVM termina de cargar. Una lectura bloqueante ingenua se queda en un bucle al 40% de CPU esperando una salida que aún no ha llegado.
La solución, tomada de JDEE (el IDE de Java para Emacs que resolvió esto en los 2000): usar poll() con un tiempo de espera. Cero CPU mientras esperas, respuesta inmediata cuando llegan datos, error limpio si la JVM no arranca. JDEE usa un patrón acumulador
para almacenar la salida parcial y buscar patrones de prompt: hacemos lo
mismo en C con strstr() sobre un búfer que crece.
La lección: el código de 1993 no necesita patrones de integración de 1993. poll(), ptys, fflush(0): son las mismas herramientas que usan Eclipse CDT y VS Code. La única diferencia es que las escribimos en 50 líneas de C en vez de 5000 líneas de TypeScript.
Cómo depuramos al depurador
Restaurar el depurador de un IDE significa depurar al propio depurador. Usamos todas las técnicas del manual, subiendo el nivel a medida que los fallos eran más profundos:
Nivel 1: fprintf a fichero. La primera herramienta. Cuando aparecieron los
artefactos de las ventanas emergentes SCREENCELL, escribíamos los valores de las celdas a /tmp/xwpe-switch-trace.txt antes y después de cada ciclo de guardado y restauración. Esto reveló que los búferes reservados con malloc contenían datos del montón sin inicializar: el arreglo fue calloc.
Nivel 2: valgrind. Cuando fprintf no bastaba, valgrind mostró
15,857 errores de valor sin inicializar del sistema de búferes schirm.
Todos se remontaban a la migración SCREENCELL, que cambió las celdas de 2 a 8 bytes sin actualizar las rutas de reserva de memoria.
Nivel 3: ficheros de traza de gdb. Para la comunicación del depurador,
registramos cada comando enviado a gdb y cada respuesta recibida: TX: r > /dev/pts/5, RX: Starting program:, RX: (gdb). Esto reveló que el patrón gnu_intstr estaba congelado en los años 90 (entrecomillado con acento grave), que print_to_end_of_buffer se paraba en las líneas en blanco y que WpeSignalChild robaba procesos hijos a pclose.
Nivel 4: reproducción independiente. Cuando la captura de salida del pty
no funcionaba, escribimos un programa C de 60 líneas que reproducía la configuración exacta de tubería+fork+pty de xwpe. La prueba funcionaba; xwpe no. La diferencia: el tiempo. La función de drenaje leía el maestro pty antes de que gdb hubiera entregado los datos. Mover el drenaje a después de call (void)fflush(0) lo arregló.
Nivel 5: trazado con compilación condicional. Para la integración con jdb,
añadimos instrumentación #ifdef JDB_TRACE por toda la ruta de comunicación del depurador. Compilar con -DJDB_TRACE, ejecutar, leer /tmp/xwpe-jdb-trace.txt. La traza mostró cada byte recibido de jdb, cada prompt detectado, cada transición de estado. Esto reveló la causa raíz: una fuga de descriptores de fichero de una tubería de 30 años de antigüedad, en la que el padre mantenía abierto el extremo de escritura de la tubería de stdout tras el fork, lo que impedía que read() detectara el EOF. El arreglo: tres
llamadas close() en el padre, tres en el hijo.
Nivel 6: poll() con tiempo de espera. Para el arranque asíncrono de la VM de jdb,
sustituimos el read() en bucle ocupado por poll() y un tiempo de espera de 10
segundos. Cero CPU mientras esperas, respuesta inmediata cuando llegan
datos, error limpio al agotarse el tiempo. Es el patrón de JDEE (Emacs)
de los 2000, implementado en C.
Cada nivel se apoyaba en el anterior. No puedes usar valgrind hasta que
fprintf te dice dónde mirar. No puedes escribir una prueba independiente
hasta que el registro de traza te dice qué es distinto. No puedes usar poll() hasta que entiendes por qué read() nunca devuelve EOF.
La infraestructura de trazado se queda en el código. Compila con -DJDB_TRACE y obtienes un registro completo del protocolo. Así es como
los desarrolladores profesionales de IDEs depuran las integraciones de depuradores: y así es como un código de 1993 aprende a hablar con una JVM de 2026, en unos cientos de líneas de C en vez de un millón de líneas de TypeScript.
La esencia
Lo que más me sorprendió es lo bien que aguanta la arquitectura central. Fred Kruse diseñó un sistema de coincidencia de patrones para los mensajes de error del compilador (${FILE}:${LINE}:${COLUMN}:*) lo bastante flexible como para manejar gcc, g++, gfortran, javac y fpc con configuración por lenguaje.
El sistema de renderizado con doble búfer (schirm/altschirm) con guardado y restauración manual es notablemente eficiente: valoramos migrar a paneles de ncurses pero concluimos que el diseño original es en realidad mejor para el caso de uso de xwpe.
Cada capa que levantábamos revelaba la siguiente. Los fallos nunca estaban en la lógica de Kruse: estaban en la integración: manejadores de señales
interactuando con pclose, estados de terminal que derivaban entre ncurses y smcup/rmcup manual, patrones de error congelados en 1993 mientras los compiladores evolucionaban. La arquitectura era sólida; solo necesitaba que alguien se sentara a escuchar lo que el código intentaba decir.
El objetivo no es reescribir xwpe. Es preservar la esencia del
código de Kruse y Payne mientras arreglamos lo que rompieron 30 años de abandono en los archivos. Una restauración, no una reconstrucción, como encontrar una vieja joya de libro en una biblioteca antigua.
En este punto me vino una analogía nueva. Creo que esto ya no es un fósil ni una vieja nave espacial en el desguace… esto sigue siendo viejo, pero algo empieza a brillar, y las luces vuelven al puente… el Halcón Milenario vuelve a volar.
El ángulo de Debian
Debian tenía xwpe en un cajón. Compilaba, así que pasaba la CI.
Andreas ha sido fundamental para facilitar el traspaso del fuente. Como patrocinador de Debian, guio la NMU que mantuvo xwpe en el archivo mientras yo montaba el nuevo fuente en Codeberg. Sin ese puente, el paquete podría haber sido eliminado de unstable antes de que el rescate pudiera empezar.
Asumir el papel de mantenedor del fuente (con la bendición de Dennis Payne) y mantener a la vez el paquete de Debian cierra el círculo. Los fallos se arreglan en el origen, no se tapan con parches, una tarea imposible en mi opinión. El paquete de Debian
se convierte en una envoltura fina alrededor de un fuente vivo.
Cerrando la lista de fallos
Repasamos a fondo la lista de correo de xwpe de 1998–2003: 487 mensajes. Los usuarios informaban de cuelgues del depurador, errores «Can’t open PIPE», fallos «Error loading program». El cuelgue del depurador de John Connor (junio de 2000). El «el proceso desaparece» de Jan Ypma en Debian (mayo de 2000). El «Can’t start the debugger» de Diego en X11 (octubre de 2000). El «viaje a La-La land» de B O’Donnell (julio de 2001). Eso me ayudó a saber qué podía resolver a continuación.
Veinte años después, podemos rastrear cada uno de ellos hasta los fallos que arreglamos:
Cuelgues del depurador: WpeSignalChild usaba wait(), que robaba los procesos hijos a pclose(). La llamada popen(«tty») para saber el nombre del terminal se quedaba colgada para siempre. Arreglado con waitpid(-1, WNOHANG).
«Error loading program»: e_comp y e_p_make llamaban a e_p_exec(-1) cuando no hacía falta recompilar, lo que provocaba un fallo fantasma de wait(). El depurador concluía que la compilación había fallado y se rendía.
Pantalla de usuario rota: la guarda #ifndef NCURSES del xwpe antiguo
desactivaba sin condiciones Ctrl-G P cuando se compilaba con ncurses: que es siempre, en todas las distribuciones Linux desde finales de los 90. Nadie pudo ver la salida del programa durante la depuración durante más de 20 años.
Parpadeo de pantalla al avanzar paso a paso: el diseño original de Kruse cambiaba
entre la pantalla alternativa y la normal (smcup/rmcup) en cada paso de F7/F8. Invisible en un vuelco de página de vídeo de DOS en 1993, pero un
destello que distrae en los terminales modernos. Lo sustituimos por un
pseudoterminal que captura la salida en memoria: cero parpadeo, y Ctrl-G P la muestra limpia.
No eran casos límite oscuros. Eran el flujo central de depuración, roto durante toda la era ncurses. Todo usuario que probó el depurador entre 2000 y 2026 se dio contra uno de estos muros.
Depuración de Java: la integración con jdb
Añadir jdb (Java Debugger) como quinto backend de depuración de xwpe destapó una fuga de descriptores de fichero de una tubería de 30 años que afectaba a TODOS los tipos de depurador. El proceso padre mantenía abierto el extremo de escritura de la tubería de stdout después del fork(), lo que impedía que read() detectara el EOF. gdb lo toleraba por accidente: su sesión nunca termina de forma inesperada. jdb, con su frágil tiempo de arranque de la JVM, chocó con ello de inmediato.
El arreglo: tres llamadas close() en el padre, tres en el hijo.
Un fallo que sobrevivió 30 años porque nadie añadió un segundo backend de depurador lo bastante estricto para destaparlo.
Investigamos cómo manejan jdb otros editores: JDEE
(Emacs, ~2003) analiza la salida de texto de jdb con un patrón acumulador. Vim tiene una envoltura básica de jdb.
Neovim usa nvim-dap con el servidor DAP java-debug. Helix, Kakoune, Micro y Nano no tienen depuración de Java en absoluto, hasta donde yo sé.
xwpe podría ser ahora mismo el único editor de terminal con depuración de Java integrada en el binario: sin plugins, sin un servidor DAP externo, sin configurar Metals ni java-debug. Abre un fichero .java, pulsa F8, pon un punto de interrupción, recorre el código paso a paso. El depurador elige jdb automáticamente cuando ve una extensión .java. Usa poll() con un tiempo de espera de 10 segundos para esperar a que arranque la JVM (el patrón acumulador de JDEE, implementado en C). La salida del programa se captura de la tubería de jdb y se muestra con Ctrl-G P.
El método era ajustado: instrumentación de traza (-DJDB_TRACE) a un lado, pruebas interactivas al otro. Ejecutar jdb, observar exactamente qué pasa: «el punto de interrupción no cambia de color», «aparece una ventana emergente pero no debería», «wpe se cierra sin preguntar»: y cada síntoma apunta a una ruta de código concreta. El fichero de traza (/tmp/xwpe-jdb-trace.txt) mostró cada byte intercambiado con jdb. Entre lo que veía en pantalla y el registro de traza, cada fallo se estrechó a una única línea de C.
El Halcón Milenario
xwpe es estos días el Halcón Milenario de los IDEs. Puede que no parezca gran cosa: 3000 líneas de C de 1993, una TUI que dibuja sus propios bordes con caracteres ACS, un motor de coincidencia de patrones para errores del compilador que usa ${FILE}:${LINE}:${COLUMN}:* en vez de expresiones regulares. Pero tiene lo que importa.
Fred Kruse lo construyó en 1993, cuando Linux tenía dos años y gcc
no tenía salida en color. Fue visionario: un ciclo
integrado de compilar-editar-depurar en terminales UNIX, años antes de que existieran Eclipse o VS Code. Que sobreviviera hasta 2006 con fallos como
el manejador SIGCHLD robando procesos hijos y la pantalla de usuario
permanentemente desactivada habla de la solidez del diseño central.
Hace lo que VS Code hace con un millón de líneas de TypeScript y
un runtime Electron. Lo hace en 3000 líneas de C, en 2MB de RAM,
sobre una conexión SSH a un servidor sin pantalla, en una Raspberry Pi, en un contenedor Docker, en una consola serie. En cualquier sitio donde tengas un terminal y un compilador de C, xwpe funciona.
Y habla tu idioma. Los usuarios de Borland tienen los menús guiados por teclas F y el ciclo de compilación F9 que recuerdan. Los usuarios de Emacs tienen Ctrl-P/N/F/Bpara mover el cursor, Ctrl-A/E para inicio y fin de línea: todos los atajos de readline que tienen en la memoria muscular. Kruse integró los dos en el mismo editor en 1993, dos décadas antes de que VS Code ofreciera «Emacs Keymap» como extensión.
La lista de correo se quedó en silencio en 2006. El último informe de usuario fue sobre
un cuelgue del depurador. Ahora sabemos exactamente por qué: wait() en vez de waitpid(), en un manejador de señales escrito en los años 90, disparado
cada vez que popen("tty") terminaba antes de que pclose() pudiera recolectarlo. Un arreglo de una línea para 20 años de silencio.
El rastro de los fallos: 487 mensajes, 50 issues, una traza
Los fallos más difíciles de encontrar son los que nadie puede reproducir de forma fiable. El cuelgue de Redo: pulsa Ctrl-R después de deshacer un buscar-y-reemplazar y mira cómo xwpe muere con SIGSEGV. Se informó en 2017 como el issue 77 en el fork de GitHub de Alessandro Magnasco. Guus Bonnema intentó investigarlo. Nadie lo arregló. El issue estuvo abierto 9 años.
Lo encontramos siguiendo un rastro a lo largo de 30 años de fuentes dispersas:
487 mensajes de la lista de correo (1998-2003) del
archivo de identicalsoftware.com de Payne, preservado en nuestro repositorio xwpe-archive
50 issues abiertos del fork de GitHub de Magnasco, triados uno a uno contra nuestro código
La reseña checa de Miroslav Janiš (1998), que documentaba el fallo del flag -c que arreglamos 28 años después
La rama experimental de Guus Bonnema, que identificó los
problemas de deshacer en buscar/reemplazar pero no pudo señalar la causa
El curso de depurador de LUG-S (2001), con capturas GIF
transcritas para nuestro manual
9 informes en el BTS de Debian entre 2002-2025
El cuelgue de Redo resultó ser un único campo sin inicializar.
Para entenderlo, piensa en xwpe como si tuviera dos cuadernos. El «cuaderno del editor» es donde la orden Replace anota «acabo de reemplazar 5 caracteres». El «cuaderno de deshacer» es donde Undo lee «¿cuántos caracteres se reemplazaron?» para saber cómo invertir la operación.
El problema: Kruse escribió la respuesta en un cuaderno (el estado global de búsqueda del editor, f->ed->fd.rn) pero la leía de un cuaderno distinto (la copia local de la ventana, b->f->fd.rn). La copia local nunca se rellenaba. Contenía la basura que hubiera en memoria cuando se creó la ventana: en nuestra traza, 189 en vez de 5.
Así que cuando Redo intentaba «rehacer el reemplazo», pensaba que necesitaba guardar 189 caracteres de una línea que solo tenía 5. Escribía más allá del final de su búfer, corrompía la contabilidad interna del asignador de memoria y se estrellaba dentro del propio malloc(): ni siquiera en el código de xwpe.
La traza de la pila mostraba unlink_chunk en lo profundo de libc, lo que es
casi imposible de diagnosticar sin saber qué llevó a la
corrupción.
Lo encontramos añadiendo un registro de traza que imprimía los campos de la entrada de deshacer antes de cada operación. El registro mostraba a=(5,189): cinco caracteres guardados, pero 189 anotados como la longitud del reemplazo. Debería haber sido a=(5,5). El 189 era la pista definitiva.
El arreglo: una línea. b->f->fd.rn = fd->rn; copiar la respuesta del cuaderno correcto al que Undo lee de verdad. Un fallo que existía desde 1993, informado en 2017, diagnosticado en 2026.
Ninguna fuente por sí sola nos habría llevado ahí. La lista de correo nos dijo
qué funciones eran frágiles. Los issues de GitHub nos dijeron qué escenarios provocaban cuelgues. La arqueología del código nos dijo qué campos estaban desincronizados.
Juntos, dibujaron un mapa hacia un arreglo de una línea para un fallo de 33 años.
El ratón: tres décadas, tres backends
Cuando abrimos we_mouse.c, encontramos 1189 líneas de lógica de interfaz de ratón: menús, barras de desplazamiento, cambio de tamaño de ventanas arrastrando las esquinas, selección de texto, arrastrar y soltar entre ventanas del gestor de ficheros. Toda la interacción que esperarías de un IDE de Borland. Todo escrito por Fred Kruse en 1993.
Y al final de we_term.c, el backend de ratón para terminal:
int fk_t_mouse(g) int *g;{ return(0);}
Cuatro líneas. Un stub. Un marcador de posición que decía: «todavía no sé cómo funcionará el ratón en los terminales, pero cuando alguien lo averigüe, que lo enchufe aquí».
El enchufe era fk_mouse: un puntero a función. El modo X11 lo ponía a fk_x_mouse (leyendo eventos ButtonPress de Xlib). El modo terminal lo ponía a este stub. Las 1189 líneas de we_mouse.c nunca supieron ni les importó qué backend estaba activo. Llamaban a fk_mouse(g) a través del puntero y recibían coordenadas. Polimorfismo Unix de libro en C.
En 1998, Sebastiano Suraci, en la Universidad de Catania, enchufó
GPM: el demonio General Purpose Mouse para la consola de Linux. Su we_gpm.c llamaba a Gpm_Open(), instalaba un callback manejador y ponía fk_mouse = WpeGpmMouse. Las 1189 líneas de interfaz de ratón funcionaron al instante. La arquitectura de Kruse aguantó.
Durante 26 años.
Después ncurses cambió. En algún momento entre ncurses 5.x y 6.x, la biblioteca añadió su propia integración interna de GPM. Cuando llamas a mousemask(), ncurses abre ahora su propia conexión GPM, lee los eventos del mismo socket y los entrega como KEY_MOUSE. Dos consumidores peleando por el mismo gpm_fd. Los eventos iban a un manejador o al otro de forma impredecible. Las coordenadas no coincidían: Suraci ponía gpm_zerobased=1
(base 0), ncurses esperaba base 1 y restaba 1 internamente.
Los clics se volvieron erráticos. A veces el menú respondía, a veces seleccionaba texto, a veces no pasaba nada.
El arreglo fue soltar el código de Suraci. No porque estuviera mal: era perfecto para 1998. Pero ncurses 6.x ya hace lo que Suraci hacía a mano. Quitamos el Gpm_Open() directo, dejamos que mousemask() maneje GPM de forma transparente y enchufamos el ratón de ncurses al stub fk_mouse de Kruse. La misma función de cuatro líneas que estaba vacía en 1993 maneja ahora los clics del ratón en xterm, gnome-terminal, kitty, tmux y la consola de Linux con GPM: todo por la misma ruta KEY_MOUSE + getmouse().
Tres backends a lo largo de tres décadas, y we_mouse.c nunca cambió.
Eso es ingeniería.
El arrastre: enseñar a un editor de 1993 a seguir tu mano
El clic funciona. El arrastre es otro mundo.
Y no solo por el ratón, esto me llevó días.
Cuando enchufamos el ratón de ncurses al stub fk_mouse de Kruse, los clics funcionaron al instante: cada menú, barra de desplazamiento y cambio de ventana se encendió a través de las 1189 líneas de we_mouse.c sin un solo cambio. Tres backends, tres décadas, la arquitectura de Kruse aguantó. Ya lo dijimos en el capítulo anterior.
Pero intenta arrastrar la barra de título de una ventana y no pasa nada. La ventana no se mueve. Tu mano recorre el trackpad y el cursor se queda ahí, parpadeando. Porque el modo 1000 de ncurses: el de por defecto: solo informa de pulsar y soltar. ¿Las cien posiciones de ratón que tu mano traza entre medias? Invisibles. El terminal no las envía. El editor nunca las ve.
Entra el modo 1002.
El protocolo que nadie documenta
El modo de ratón 1002 de xterm (\033[?1002h) es el protocolo de seguimiento de arrastre.
Mientras un botón está pulsado, el terminal envía un evento REPORT_MOUSE_POSITION por cada celda que cruza el cursor. Así es como Midnight Commander hace el cambio de tamaño de paneles. Así es como tmux hace el arrastre de paneles. Así es como vim hace la selección visual entre líneas. No el modo 1000 (solo clics), no el modo 1003 (todo movimiento, incluso sin botones: inunda la entrada), sino 1002: movimiento mientras se mantiene el botón. Exactamente lo que necesita el arrastre de ventanas.
Lo activamos en el inicio del terminal. Dos secuencias de escape: \033[?1002h\033[?1006h. La segunda activa las coordenadas extendidas SGR: sin ella, los terminales de más de 223 columnas codifican basura porque el byte de coordenada X10 se desborda. Ambas se desactivan limpiamente al salir.
Y de repente, fk_t_mouse estaba recibiendo un flujo continuo de
coordenadas. ¡Los bucles de arrastre de Kruse en we_mouse.c: escritos en 1993 para los eventos MotionNotify de X11: empezaron a mover ventanas en ncurses! La barra de título seguía al ratón. Los manejadores de cambio de tamaño de las esquinas funcionaban. Tres décadas de código de arrastre dormido, despertando porque los dos bytes correctos se enviaron al terminal en el inicio.
La trampa de la ventana emergente
Funcionaba a la perfección. Hasta F9.
Pulsa F9 para compilar. Aparece la ventana emergente «Compiling…», el compilador se ejecuta, los resultados van a Messages. Cierra Messages. Ahora intenta arrastrar una ventana.
La barra de título agarra: y no suelta nunca. La ventana sigue a tu ratón para siempre, incluso después de soltar el botón. La interfaz se queda atrapada en un bucle de arrastre infinito.
La causa raíz necesitó tres soluciones provisionales fallidas antes de que dejáramos de parchear y empezáramos a hacer ingeniería.
Esto es lo que pasa. El usuario está clicando tan contento: e_mouse.k dice «botón 1 pulsado» o «botón 1 soltado» y todo funciona. Entonces se abre la ventana emergente de F9. La ventana emergente tiene su propio bucle de eventos. Dentro de ese bucle, ncurses entrega un evento PRESSED (el clic que activó algo dentro de la ventana) y su evento RELEASED correspondiente. El bucle de eventos de la ventana se consume los dos. Sale.
Ahora fk_t_mouse se ejecuta en el bucle de eventos principal. Lee e_mouse.k, que todavía dice «pulsado» por el ÚLTIMO evento que vio el bucle principal: antes de que la ventana emergente robara el soltado. El bucle de arrastre empieza. Pero el botón físico está soltado. No llegará nunca ningún evento RELEASED (la ventana emergente ya se lo comió). El bucle de arrastre espera para siempre.
Estudiamos cómo manejan esto otros frameworks de TUI:
Midnight Commander: usa flags de captura de ratón por widget.
El widget activo reclama el ratón, y cuando lo suelta, el flag se limpia. Pero MC no tiene el gestor de ventanas apilables de xwpe con ventanas emergentes arbitrarias.
Turbo Vision (el framework de TUI en C++ de la propia Borland, de 1990):
usa un bucle de arrastre exclusivo con GetMouseEvent en un bucle while(button_held) apretado. El bucle es dueño del ratón hasta que se suelta. Las ventanas emergentes no pueden interrumpir porque el bucle de arrastre no cede al despachador de eventos.
El propio ncurses: no proporciona ningún estado de ratón consciente de las ventanas emergentes.
Informa de eventos. Lo que hagas con ellos es tu problema.
Ni la captura por widget de MC ni el bucle exclusivo de Turbo Vision
encajan en la arquitectura de xwpe. El diseño de Kruse despacha los eventos de ratón
a través de un puntero a función (fk_mouse), y el código de arrastre en we_mouse.c asume que recibe una secuencia limpia de pulsar-arrastrar-soltar. Las ventanas emergentes rompen esa suposición.
g_mouse_buttons: una máscara de bits para gobernarlas a todas
La solución: separar el estado físico de los botones del despacho de eventos.
int g_mouse_buttons = 0;
Un entero global. El bit 0 es el botón 1. Se actualiza en exactamente dos sitios: e_t_getch (el lector de teclado) pone el bit en PRESSED y lo limpia en RELEASED. fk_t_mouse (el despachador de ratón) leeg_mouse_buttons para decidir si hay un arrastre en marcha, en vez de fiarse de e_mouse.k.
La clave: e_t_getch siempre ve todos los eventos de ratón, incluso dentro de los bucles de eventos de las ventanas emergentes, porque las ventanas emergentes también llaman a e_t_getch. Así que g_mouse_buttons siempre refleja el estado físico real. Cuando el bucle de eventos de la ventana procesa un evento RELEASED, g_mouse_buttons limpia el bit. Cuando la ventana sale y el bucle principal se reanuda, fk_t_mouse lee g_mouse_buttons = 0 y sabe: no hay arrastre. Sin
ratón atascado. Sin bucle infinito.
Pero eso es solo la mitad del arreglo.
e_mouse_flush: drenando a los muertos
Después de que se cierra una ventana emergente, la cola de eventos de ncurses puede seguir conteniendo eventos de ratón viejos: RELEASED fantasma de clics dentro de la ventana, o eventos de movimiento de la mano del usuario mientras la ventana estaba abierta. Si llegan a fk_t_mouse antes de un clic nuevo, confunden a la máquina de estados.
Peor: ncurses a veces desactiva en silencio el modo 1002 durante el procesamiento de eventos de la ventana emergente. El manejador de secuencias de escape se confunde con la salida de la ventana y el seguimiento de arrastre se detiene. El terminal deja de enviar eventos de movimiento. El siguiente intento de arrastre falla en silencio: clicas la barra de título, mantienes el botón, mueves y no pasa nada. Sin error, sin diagnóstico, solo un ratón muerto.
e_mouse_flush() arregla los dos problemas:
Drenar: bucle de getmouse() hasta que devuelva ERR: vaciar la
cola de eventos viejos.
Reactivar: reenviar \033[?1002h\033[?1006h: forzar el modo 1002 de vuelta, sin importar lo que ncurses hiciera internamente.
Reiniciar: g_mouse_buttons = 0: empezar desde un estado conocido.
Se llama a la salida de e_mess_win (el manejador de mensajes emergentes) y e_opt_kst (el manejador de opciones y diálogos). Toda ruta de código que abra una ventana emergente y procese sus propios eventos de ratón debe llamar a e_mouse_flush al salir.
La prueba
Tres ventanas abiertas. Dos ficheros de código fuente y Messages. Arrastra cada ventana por su barra de título: suave, continuo, sigue la mano. Pulsa F9 : el compilador se ejecuta, aparece Messages. Arrastra Messages hacia abajo, arrastra una ventana de fuente hacia arriba, arrastra la tercera ventana. Suelta. Clica en otro sitio.
Todo funciona.
El registro del ratón muestra la prueba: gb=1 (bit 0 de g_mouse_buttons puesto) durante todo el arrastre, bstate=0x10000000 (REPORT_MOUSE_POSITION) para cada evento de movimiento, bstate=0x1 (BUTTON1_RELEASED) al final de cada arrastre. Sin pulsaciones huérfanas, sin estados atascados, sin caídas del modo 1002.
Trescientas líneas de eventos de ratón, y todas y cada una caen
en el patrón: pulsar, movimiento continuo, soltar. Pulsar, movimiento, soltar. La máquina de estados nunca se rompe. La máscara de bits nunca miente.
El we_mouse.c de Kruse: 1189 líneas de manejadores de arrastre, de
cambio de tamaño, de menú, de desplazamiento: nunca supo que nada de esto
pasaba. Llamaba a fk_mouse(g), recibía coordenadas limpias y movía ventanas. El mismo puntero a función, la misma abstracción, la misma arquitectura. De 1993 a 2026.
El reacomodo: ventanas que recuerdan dónde pertenecen
El arrastre no sirve de nada si el cambio de tamaño destruye tu disposición.
Cuando el terminal cambia de tamaño (SIGWINCH en ncurses, ConfigureNotify en X11), se vuelve a reservar el búfer de pantalla y todas las ventanas deben adaptarse.
El enfoque ingenuo: recortar las coordenadas a los nuevos límites. Funciona al reducir pero falla al crecer: las ventanas que se empujaron al borde durante una reducción nunca recuperan su espacio cuando el terminal vuelve a crecer.
El problema de fondo: deriva de proporciones. Si tienes una ventana en la fila 15 de
30, y el terminal se reduce a 20 filas, el truncamiento entero la pone
en la fila 10. Vuelve a crecer a 30: el truncamiento la pone en la fila 15. Parece
correcto. Pero hazlo 50 veces: reducir 1, crecer 1, reducir 1,
crecer 1: y el error de truncamiento acumulado va andando lentamente la
ventana hacia la parte de arriba de la pantalla.
Diseñamos un algoritmo de anclaje a los bordes:
Para cada coordenada de ventana, comprobar si tocaba un borde de la pantalla antes del cambio de tamaño. Una ventana cuyo borde inferior estaba en MAXSLNS - 2 (la última fila útil) está «anclada abajo»: su borde inferior sigue al borde de la pantalla. Una ventana cuyo borde superior está en la fila 1 está «anclada arriba»: se queda en la fila 1. Las coordenadas interiores: que no tocan ningún borde : se escalan de forma proporcional redondeando al más cercano:
int e_scale_y(int y, int old_h, int new_h){ return (y * new_h + old_h / 2) / old_h;}
El término old_h / 2 es la corrección de redondeo al más cercano. Sin él, 15 * 20 / 30 = 10, luego 10 * 30 / 20 = 15: parece reversible.
Pero 7 * 20 / 30 = 4 (truncado de 4.67), luego 4 * 30 / 20 = 6: has perdido una fila. Acumulado en muchos ciclos, la ventana se colapsa. Con redondeo: 7 * 20 + 15 = 155, / 30 = 5 (redondeado de 4.67), luego 5 * 30 + 10 = 160, / 20 = 8: sobrecorrige en uno, pero el error no se acumula. La ventana oscila una fila en vez de derivar de forma monótona.
Tres ventanas, Messages abajo, el terminal reduciéndose y
creciendo a lo bruto: cada ventana se queda donde debe. El editor
ocupa los dos tercios de arriba, Messages ocupa el tercio de abajo, y las
proporciones se mantienen.
Renderizado a prueba de límites
Un muro más entre el arrastre y el cuelgue: SCHIRM_INBOUNDS.
Cuando un diálogo es más ancho que el terminal (común durante una reducción
extrema), el bucle de renderizado intenta escribir celdas más allá de la
reserva de schirm. En 1993 los terminales no cambiaban de tamaño. En 2026, cada arrastre
del borde de un WM en mosaico provoca un cambio de tamaño. Escribir más allá de la reserva
corrompe el montón: cuelgues aleatorios segundos o minutos después.
Toda macro de acceso a schirm: e_pr_char, e_gt_char, e_gt_col, e_pt_col, e_gt_flags, e_pt_flags: comprueba los límites antes de
tocar memoria. Las escrituras fuera de límites se descartan en silencio. El
diálogo renderiza la parte que cabe; la parte más allá del borde del terminal es invisible. Haz crecer el terminal de vuelta y el diálogo reaparece
completo. Sin cuelgue, sin corrupción, sin estado que recuperar.
Es el mismo patrón que usan los emuladores de terminal modernos (st,
alacritty, foot): el modelo puede ser más grande que la vista, y la
vista recorta en silencio. El renderizador nunca escribe fuera de la vista.
Lo que Kruse sabía
Kruse escribió fk_t_mouse como un stub de cuatro líneas que devolvía cero.
Escribió fk_mouse como un puntero a función. Escribió 1189 líneas de
lógica de arrastre en we_mouse.c que nunca mencionaban X11 ni ncurses ni
GPM.
En 1993, el único backend de ratón que funcionaba era X11 (fk_x_mouse). Los ratones de terminal aún no existían: GPM era experimental, el soporte de ratón de xterm era rudimentario. Pero Kruse diseñó la separación de todos modos.
No podía saber que existiría el modo 1002, que ncurses
añadiría mousemask(), que GPM sería absorbido por ncurses, que las ventanas emergentes desincronizarían el estado de los botones. Pero diseñó una arquitectura que sobrevivió a todo eso.
Añadimos g_mouse_buttons, e_mouse_flush, e_relayout_windows y SCHIRM_INBOUNDS. Cuatro mecanismos, cada uno resolviendo un problema que no existía en 1993. Y we_mouse.c: el fichero que de verdad mueve las ventanas, las redimensiona, selecciona texto y desplaza contenido, no cambió en absoluto.
Eso no es suerte. Eso es diseño de Kruse.
El problema fantasma de X11
El renderizado X11 de Kruse usaba Xlib en crudo: XDrawImageString para el texto, XDrawLine para los bordes de las ventanas, gestión manual de píxeles para todo.
Un array llamado extbyte rastreaba qué celdas tenían segmentos de línea de borde.
Cuando se cerraba una ventana emergente o el gestor de ficheros, los píxeles del borde persistían en la ventana X11: imágenes fantasma que no se iban.
El fallo era arquitectónico: extbyte es un array plano sin ningún concepto de apilamiento de ventanas. Una ventana detrás del editor podía tener sus flags de borde puestos, y e_x_refresh dibujaba diligentemente esos segmentos XDrawLine encima del contenido del editor. El arreglo que por fin funcionó: limpiar extbyte del interior de cada ventana de la pila en cada refresco. Pragmático, no elegante: pero atrapa todas las rutas de código.
Dennis Payne vio esto venir. En su fichero TODO escribió: «Usar
APIs de más alto nivel en vez de xlib y de la interfaz curses más baja».
Sabía que el renderizado a nivel de píxel era una trampa de mantenimiento.
El problema de la salida: de xterm a Messages
En el diseño original de Kruse, la salida del programa depurado iba al terminal (a través del cambio de pantalla smcup/rmcup). En modo X11, Payne añadió una ventana xterm: un script de shell que lanzaba el depurador dentro de un xterm mediante tuberías con nombre. El xterm robaba el foco del teclado, se cerraba antes de que pudieras leer la salida y dejaba xwpe sin respuesta si algo iba mal.
Unificamos la salida del programa para el modo terminal y el modo X11 en el búfer Messages: la misma ventana usada para los errores del compilador (F9). Ahora Ctrl-G P (pantalla de usuario) añade la salida del programa a Messages con desplazamiento completo. Ctrl-F9 Run para lenguajes interpretados (Python, LaTeX) captura la salida con popen() directamente en Messages, evitando xterm por completo.
Sin cambio de contexto, sin robo de foco, sin ventana que cerrar.
El mismo enfoque que Borland habría usado si su IDE hubiera funcionado en
UNIX: un panel de salida, varios usos, siempre accesible.
Siguiendo a st: la migración a Xft
La pieza final del rompecabezas X11 eran las fuentes. Kruse usaba XDrawImageString, que es solo Latin-1. Sin caracteres acentuados, sin cirílico, sin emoji. En modo terminal, ncursesw se encarga de todo:
la pila de fuentes del emulador de terminal hace el trabajo. En modo X11, xwpe ES el renderizador.
Primero probamos un enfoque híbrido: Xft para algunos caracteres,
XDrawImageString para otros. Falló estrepitosamente. Los dos sistemas de renderizado usan métricas distintas, estado GC distinto, semántica de relleno de fondo distinta. Mezclarlos produjo fondos blancos, texto invisible y artefactos de borde. Cada arreglo parcial rompía otra cosa.
Dejé de parchear y tomé la decisión: implementar por completo la recomendación de Payne: ir a Xft para todo: en vez de parchear el híbrido. Fue más rápido que perseguir un arreglo parcial más, y fue la decisión correcta.
Estudiamos el código de st (suckless terminal)
y leímos cómo renderiza el texto. st usa Xft para el 100% de su renderizado: ni un XDrawImageString en ningún sitio. Los patrones que adoptamos:
XftDrawRect para el relleno de fondo (una llamada por celda)
XftDrawStringUtf8 para el texto (con fuente de reserva por carácter)
Caché de fuentes (array frc[]): búsqueda en fontconfig una vez por punto de código, en caché para siempre. El mismo patrón que st, la misma estructura de datos.
XftDraw sobre Pixmap: todo el renderizado va a un Pixmap fuera de pantalla, XCopyArea a la ventana al final. Cero parpadeo al cambiar de tamaño.
FC_COLOR para la reserva de emoji: fontconfig prefiere Noto Color Emoji para los puntos de código por encima de U+2600
La migración tocó we_xterm.c (renderizado), WeXterm.c (inicio de fuentes), WeXterm.h (campos Xft), configure.ac (detección de Xft) y Makefile.am (flags de enlazado). La ruta XDrawImageString original se conserva dentro de #else para los sistemas sin Xft.
Con libXft 2.3.5+ (distribuido en Debian desde 2022), el renderizado de emoji en color BGRA funciona de forma nativa. La misma llamada XftDrawStringUtf8 que renderiza hello también renderiza hello 🎉 con un glifo de emoji a todo color de Noto Color Emoji.
El problema de los caracteres anchos
Los emoji y los caracteres CJK ocupan dos columnas en pantalla (wcwidth() = 2).
Pero el búfer SCREENCELL de xwpe guarda un carácter por celda. Cuando un emoji ocupa las celdas 5 y 6, la celda 6 necesita saber que es la
«continuación» de la celda 5: si no, el cursor la trata como un
carácter independiente, borrar elimina solo la mitad y el renderizado dibuja un rectángulo de fondo sobre la segunda mitad.
Estudiamos cómo manejan esto st, vim, alacritty y libvterm. Todas las
implementaciones convergen en el mismo patrón: bits de flag en la celda.
Añadimos un campo flags a SCREENCELL con dos valores:
CELL_WIDE en la primera celda (el emoji en sí)
CELL_WIDE_SPACER en la segunda celda (la continuación)
El código de renderizado se salta las celdas espaciadoras. El cursor salta sobre ellas.
Borrar elimina las dos celdas. Los clics de ratón sobre una espaciadora se asignan al carácter ancho. El mismo patrón de mantenimiento de invariantes de st: cada operación de escritura comprueba los dos flags y limpia la celda compañera.
Este es un cambio transversal: toca unixmakr.h (la estructura), we_wind.c y we_progn.c (renderizado), we_edit.c (cursor y borrado) y we_mouse.c (asignación de clics). Pero el patrón es limpio y está bien probado en toda la industria.
Python, LaTeX y el patrón de los lenguajes de script
El ciclo 1.6.2 añadió soporte completo para lenguajes interpretados:
Python: resaltado de sintaxis de 35 palabras clave, F9 vía python3 -m py_compile,
pdb como sexto backend de depuración (puntos de interrupción, pasos con F8, salto automático de
los marcos internos de Python, captura de salida).
LaTeX: resaltado de sintaxis de 31 palabras clave, F9 vía pdflatex -interaction=nonstopmode -file-line-error, navegación por errores.
Ctrl-F9 Run detecta los lenguajes interpretados (comp_sw & 1) y ejecuta el intérprete directamente con popen(), capturando la salida a
Messages. Sin xterm, sin gestión de subprocesos, sin robo de foco.
El patrón es extensible. Añadir un compilador nuevo lleva unas ~10 líneas en we_prog.c (nombre del compilador, flags, patrón de error, extensiones de fichero). Si el compilador emite el formato file:line:column: (el estándar GNU desde 2013), funciona con cero configuración.
En v1.6.3 añadimos Perl (perl -c, resaltado de sintaxis de 46 palabras clave, ejecución con Ctrl-F9) y COBOL (cobc, resaltado de sintaxis de 50 palabras clave, modo GNU), lo que lleva el total a 9 compiladores por defecto.
Estado
v1.5.31: publicación de rescate (base de Payne + cherry-picks + parches de Debian)
v1.6.0: migración UTF-8/SCREENCELL, cambio de tamaño de terminal, teclas modernas
v1.6.2: la publicación que trajo xwpe de 1993 a 2026:
v1.6.3 (publicada en 2026-06, en Debian unstable): la publicación de usabilidad.
El fósil vive. Compila tu código, navega por tus errores, recorre
tus funciones paso a paso, te muestra la salida: con fuentes TrueType
suavizadas, emoji en color y UTF-8 del terminal a X11. Y ahora se siente bien bajo los dedos: Tab recorre los diálogos, los colores son legibles, Shift-Tab va hacia atrás, los errores siguen al cursor.
Fred Kruse construyó la arquitectura en 1993. Dennis Payne la mantuvo durante una década. Nosotros la trajimos a 2026, siguiendo los patrones de renderizado de st y las convenciones de caracteres anchos de la industria. El código pasó de las fuentes de mapa de bits y Latin-1 a fontconfig y Noto Color Emoji: y el diseño
central aguantó. Cada puntero a función, cada doble búfer, cada comparador de patrones que Kruse escribió sigue haciendo exactamente lo que fue diseñado para hacer.
Solo le dimos mejores herramientas con las que trabajar.
xwpe 1.6.3 está, a fecha de la publicación de esta entrada, en Debian unstable. El mismo binario está verificado de extremo a extremo en
gracias a una nueva adición: 134 pruebas de consola y 58 pruebas X11 sin pantalla pasan contra el paquete instalado, así que «compila» es ahora «funciona».
Y la parte que aún me llega: Fred Kruse, que escribió esa primera versión en 1993, ha estado en contacto. Quiere probarlo. Treinta y tres años después de que lo construyera, y dos décadas después de la última publicación, el autor original quiere ver su editor funcionar otra vez. Dennis Payne dio su bendición al traspaso; Kruse le dio su significado al rescate.
Cuando v1.7 llegue con soporte DAP (Debug Adapter Protocol): depuración de Rust, Go, JavaScript y C# desde una TUI de 1993: ese será el debut público del Halcón Milenario. Por ahora, vuelve a volar.
Antes y después:
Xwpe 1.5.30: sin soporte de UTF-8. Estilo antiguo de barras de desplazamiento
XWPE 1.6.3, mostrando la salida de Ctrl-F9 en la ventana Messages
Probando XWPE en Wayland con soporte de UTF-8, abriendo un fichero con «emojis». «El problema de la celda ancha»
Nueve días depurando una sola llamada a una función, y otras lecciones de la integración con un motor de navegador
Introducción
Cuando Stremio publicó su nuevo shell basado en GTK4 usando Chromium Embedded Framework (CEF) en lugar de Qt5/QtWebEngine, proporcionó el caso de prueba perfecto para mi camino en el empaquetado de Debian, sobre todo después de que QT5 se haya convertido en software con el ciclo de vida terminado que pronto dejará de tener soporte.
Era el buen caso de uso para probar nuestra librería CEF recién empaquetada. Lo que siguió fue un mes de depuración que reveló la brecha entre «la librería compila» y «la librería funciona».
Este artículo documenta los retos técnicos de integrar CEF con una aplicación del mundo real para el empaquetado en Debian.
La arquitectura de la aplicación
Stremio-gtk es una aplicación relativamente simple en concepto:
Crear una ventana de navegador CEF
Cargar https://app.strem.io/shell-v4.4
Proporcionar un puente de IPC para que la aplicación web controle las funciones nativas
Gestionar la reproducción de vídeo a través de MPV
En la práctica, cada paso reveló complejidad oculta.
Reto 1: descubrimiento de los ficheros de recursos
El problema
Los procesos de CEF necesitan localizar varios ficheros de recursos al arrancar:
icudtl.dat – Datos de internacionalización de ICU
v8_context_snapshot.bin – Instantánea del motor JavaScript V8
Ficheros *.pak – Paquetes de recursos de Chromium
locales/*.pak – Datos de localización
En las compilaciones del fuente original, estos ficheros están junto al ejecutable. En las instalaciones que cumplen el FHS, están repartidos por /usr/share/cef/.
La solución obvia es configurar las rutas en la estructura Settings:
let settings = Settings { resources_dir_path: "/usr/share/cef".into(), locales_dir_path: "/usr/share/cef/locales".into(), ..Default::default()};cef_initialize(&settings);
Esto funciona para el proceso del navegador. Los subprocesos fallaban de inmediato.
La causa raíz
La arquitectura multiproceso de CEF lanza subprocesos especializados para el renderizado, las operaciones de GPU y las funciones de utilidad. Estos subprocesos llaman a cef_execute_process() como primera acción y salen sin llegar nunca a ver la estructura Settings.
El punto de entrada del subproceso:
fn main() { // For subprocesses, this returns immediately with exit code let exit_code = cef_execute_process(&args, None, None); if exit_code >= 0 { std::process::exit(exit_code); } // Only browser process reaches here let settings = Settings { ... }; cef_initialize(&settings);}
Cuando Settings se podía aplicar, los subprocesos ya habían fallado al buscar los recursos.
Solución
CEF busca los recursos de forma relativa a libcef.so, no al binario de la aplicación. Unos enlaces simbólicos en el directorio de librerías resuelven el problema:
# In /usr/lib/x86_64-linux-gnu/:icudtl.dat -> ../../share/cef/icudtl.datv8_context_snapshot.bin -> ../../share/cef/v8_context_snapshot.bin
Para la configuración que los subprocesos necesitan, hay que añadir opciones de línea de comandos en el callback on_before_command_line_processing, que se llama para todos los tipos de proceso:
Con los recursos cargando correctamente, el subproceso de GPU ya arrancaba, y fallaba de inmediato. CEF lo reintentó nueve veces antes de rendirse:
[GPU] error_code=1002GPU process isn't usable. Goodbye.
Sin trazas de pila, sin registros útiles. El proceso de GPU moría antes de producir diagnósticos.
Investigación
Añadir --enable-logging --v=1 reveló que el proceso de GPU fallaba al inicializar los contextos OpenGL. El error sugería problemas con las librerías EGL/GLES.
El proceso de GPU de CEF espera ANGLE (Almost Native Graphics Layer Engine), la implementación de OpenGL ES de Google construida sobre Vulkan y DirectX. No es intercambiable con la implementación EGL de Mesa a pesar de que las APIs se parecen.
Solución
El paquete de CEF debe incluir sus propias librerías ANGLE:
Las rutas relativas fallaban porque el cargador del ICD no resuelve las rutas de forma relativa al fichero JSON.
Reto 3: la depuración de IPC de nueve días
El síntoma
CEF arrancaba, las páginas cargaban, la interfaz se renderizaba, pero la reproducción de vídeo caía en HTML5 en lugar del reproductor nativo MPV. La aplicación web trataba stremio-gtk como un navegador en lugar de como un shell nativo.
El protocolo Qt WebChannel
La aplicación web de Stremio espera comunicarse con su shell nativo a través del protocolo WebChannel de Qt. El shell Qt5 original crea un objeto transport:
Examinar el fuente de la aplicación web reveló una comprobación temprana:
if (navigator.userAgent.indexOf('StremioShell') === -1) { // Use HTML5 player return;}// Use native MPV
Añadí «StremioShell» al user agent. El vídeo seguía sin funcionar.
Día 9: la llamada a la función que faltaba
Desesperado, leí el main.qml del shell Qt5 línea por línea:
function injectJS() { var injectedJS = "try { initShellComm() } catch(e) { console.error(e) }" webView.runJavaScript(injectedJS, function(err) { if (err) console.error("Injection failed:", err); });}Connections { target: webView onLoadingChanged: { if (loadRequest.status === WebEngineLoadRequest.LoadSucceededStatus) { injectJS(); } }}
El shell nativo debe llamar explícitamente a window.initShellComm() después de la carga de la página. La aplicación web define esta función pero nunca la llama automáticamente.
Nueve días depurando formatos de IPC, serialización y tipos de mensaje. La corrección real fue una llamada a una función que el shell Qt5 hacía explícitamente. La documentación existía, en código QML que había que leer línea por línea.
Reto 4: renderizado de widgets nativos
El problema
Después de que el IPC funcionara, quedaba un problema menor pero visible: los desplegables <select> de HTML no funcionaban. Hacer clic en ellos no hacía nada.
La causa raíz
El modo de renderizado fuera de pantalla de CEF (el que usa stremio-gtk) renderiza todo a un búfer mediante OnPaint. Los widgets nativos del sistema operativo, como los menús desplegables, requieren manejadores de ventana reales.
CEF proporciona callbacks para el renderizado de ventanas emergentes:
Las aplicaciones deben implementarlos para renderizar ellas mismas las representaciones de los widgets nativos. Stremio-gtk no los había implementado.
Solución pragmática
En lugar de implementar el renderizado completo de ventanas emergentes, la inyección de JavaScript reemplaza los elementos <select> por desplegables propios basados en div:
Los elementos <select> nativos ocultos sincronizan el estado para la compatibilidad con AngularJS.
El recuento final de parches
Después de toda la depuración, stremio-gtk necesitó 24 parches:
Categoría
Cantidad
Ejemplos
Sistema de compilación
4
Cargo vendor, rutas del sistema
Integración con CEF
6
Rutas de recursos, ANGLE, zygote
Protocolo de IPC
8
Objeto transport, formato JSON, initShellComm
Correcciones en tiempo de ejecución
4
User agent, señales de eventos
Apaños de interfaz
2
Reemplazo de select, manejo del foco
Observaciones sobre las pruebas
Lo que las pruebas unitarias no detectan
El paquete de CEF pasó todas sus pruebas. Stremio-gtk reveló:
Se necesitaban enlaces simbólicos de recursos en ubicaciones inesperadas
ANGLE es obligatorio, no opcional
La inicialización de los subprocesos difiere de la del proceso principal
Los detalles del protocolo de IPC importan para las aplicaciones reales
El valor de las pruebas de integración
Una aplicación exigente como stremio-gtk (vídeo, IPC, GPU, renderizado fuera de pantalla) estresa funciones que las pruebas simples de «cargar una página web» no tocan nunca.
Descubrimiento de bugs en el fuente original
Existen varios problemas en el stremio-linux-shell del fuente original. El Flatpak probablemente funciona por accidente del empaquetado o de los tiempos. Estas correcciones deberían volver al fuente original.
Conclusión
El empaquetado de stremio-gtk reveló que integrar CEF es más que enlazar contra una librería. La arquitectura multiproceso, el descubrimiento de recursos, los requisitos de GPU y los protocolos de IPC requieren un manejo cuidadoso para el empaquetado en distribuciones.
La depuración de IPC de nueve días produjo una línea de código real. Los otros 23 parches requirieron entender internos que no están documentados en ninguna parte salvo en el código fuente de las implementaciones que funcionan.
Para los empaquetadores que consideren aplicaciones CEF: espera tener que cerrar la brecha entre las suposiciones del fuente original y los requisitos de la distribución. Lee la implementación Qt5 si existe. Prueba pronto y prueba a fondo.
Resolver el ITP #915400 tras siete años: el desglose técnico completo
Introducción
El Chromium Embedded Framework (CEF) lleva en la cola de empaquetado de Debian desde diciembre de 2018. El bug #915400 documentaba la necesidad: obs-studio quería fuentes de navegador, casparcg-server necesitaba soporte HTTP y varias aplicaciones requerían una alternativa más ligera a Electron.
Anteriormente empaqueté Stremio (basado en QT5) para Debian y Wolfi, pero QT5 está EOL (fin de vida), así que seguí adelante y decidí empaquetar la siguiente generación de Stremio (basada en GTK), pero este paquete depende de chromium-embedded-framework, que no existía en Debian.
Este artículo documenta el enfoque técnico que por fin produjo paquetes de Debian que funcionan.
Por qué CEF es distinto
La mayoría de los proyectos C/C++ siguen un patrón predecible: descargar el tarball, ejecutar configure, make, install. CEF rompe todas las suposiciones.
El proceso de compilación upstream
La compilación oficial de CEF usa automate-git.py, que:
Clona depot_tools de Google
Ejecuta gclient sync para descargar ~1GB de fuentes de Chromium
Descarga cadenas de herramientas precompiladas de Google Cloud Storage
Opcionalmente usa reclient para la compilación distribuida
Compila las configuraciones Debug y Release
Crea paquetes de distribución binaria
Este proceso asume acceso a internet, infraestructura de Google y un directorio de trabajo de ~90GB.
Requisitos de Debian
Las compilaciones de Debian deben:
Estar aisladas de la red durante la compilación
Ser reproducibles desde el fuente
Usar las cadenas de herramientas del sistema cuando sea posible
Cumplir el Filesystem Hierarchy Standard
La brecha entre estos requisitos y las suposiciones del fuente original provocó la mayor parte de la complejidad del empaquetado.
Arquitectura: el enfoque de doble fuente
Problema: la integración de Chromium
CEF no incluye Chromium en su tarball. Espera descargarlo durante la compilación. Incluir las fuentes de Chromium en el tarball orig de CEF:
Crearía un paquete fuente de ~1.5GB
Duplicaría las fuentes de chromium que ya existen en Debian
Crearía una carga de mantenimiento al seguir dos proyectos
El Chromium de Debian no proporciona un paquete de fuentes que podamos usar como dependencia. Para superar eso, vamos a crear un paquete de Debian experimental que tomará las fuentes del Chromium de Debian y las añadirá como dependencia en una subcarpeta. Este enfoque permitirá a otros desarrolladores de Debian opinar y comprobar que esta solución funciona y, cuando el equipo de Chromium de Debian publique por fin las fuentes, solo tendremos que añadirlas como una dependencia normal.
Solución: modelo de dependencia de compilación
El empaquetado trata Chromium como una dependencia de compilación en lugar de como fuente incluido:
El fichero debian/rules extrae las fuentes de Chromium en chromium_src/ antes de que empiece la compilación. Esto ocurre en el target clean para asegurar que las fuentes existen antes de cualquier paso de compilación.
Ventajas
Reutilizar el trabajo del Chromium de Debian: cuando el equipo de chromium parchea una vulnerabilidad, CEF puede hacer rebase
Paquete fuente más pequeño: solo las fuentes específicas de CEF en el tarball orig
Separación clara: los parches de CEF y los de Chromium son distintos
Futuro: paquete chromium-source
El bug #893448 propone un paquete binario chromium-source que proporcionaría las fuentes de Chromium extraídas. Cuando se resuelva, CEF podría simplemente Build-Depends: chromium-source y la extracción manual del tarball desaparecería.
La pila de parches
Parches de CEF (16 en total)
Desacoplar el sistema de compilación
0001-skip-gclient-revert.patch
El gclient_hook.py de CEF revierte todos los ficheros al estado de git checkout HEAD antes de compilar. Esto destruye cualquier parche de Debian aplicado durante la compilación. El parche elimina la lógica de reversión.
0002-skip-chromium-checkout.patch
CEF espera ejecutar git clone para Chromium. Este parche se salta el checkout y usa fuentes preextraídas.
0003-use-system-clang.patch
CEF descarga cadenas de herramientas LLVM de Google Cloud Storage. Este parche configura la compilación para usar el paquete clang-19 de Debian.
0004-create-reclient-stub.patch
El reclient de Google proporciona compilación distribuida. En lugar de eliminar todas las referencias, un script stub satisface al sistema de compilación sin acceso a la red.
0005-add-rust-toolchain-stub.patch
Parecido a reclient: un stub para el descargador de la cadena de herramientas de Rust que delega en el rustc del sistema.
La compilación de Chromium obtiene recursos en varios puntos. Cada punto de descarga necesita un parche para:
Usar alternativas preempaquetadas
Saltarse componentes opcionales
Fallar con un error claro en lugar de colgarse
Compatibilidad con C++23 / libc++ (8 parches)
Debian sid usa libc++-19 con una aplicación estricta de C++23. El destructor de unique_ptr ahora requiere tipos completos:
// Old code (worked in C++17/20):class RenderFrame;std::unique_ptr<RenderFrame> frame_; // OK: RenderFrame forward-declared// C++23 libc++:// Error: RenderFrame must be complete for ~unique_ptr
Los parches añaden declaraciones anticipadas y reordenan los includes en:
v8/src/heap/ – Internos del recolector de basura
media/gpu/ – Aceleración de vídeo
ui/gfx/ – Primitivas gráficas
components/viz/ – Compositor
Corrección de ejemplo en v8/src/heap/marking-state.h:
// Before patch:class HeapObject;std::unique_ptr<HeapObject> obj_;// After patch (add include):#include "src/objects/heap-object.h"std::unique_ptr<HeapObject> obj_;
Actualizaciones del compilador (6 parches)
GCC 15 y Clang 19 marcaron como obsoletas varias construcciones:
fix-aggregate-optional-emplace.patch
El comportamiento de std::optional::emplace con inicialización por agregados cambió. Código afectado en la serialización de IPC.
remove-deprecated-warning-flags.patch
Varias opciones -W ya no existen en clang-19.
fix-libclang-paths.patch
Las rutas internas de cabeceras de Clang cambiaron entre versiones.
Rust estable (3 parches)
Chromium usa características de Rust nightly. Los parches eliminan:
Opciones -Z (inestables)
Características de crates solo de nightly
Funciones de librería inestables
Librerías del sistema (8 parches)
Parches para preferir las librerías del sistema cuando son compatibles a nivel de ABI:
libxcb
fontconfig
minizip
zstd
harfbuzz (parcial)
Algunas librerías no pueden usar las versiones del sistema por diferencias de ABI (V8, Skia, ANGLE).
Configuración de la compilación
Argumentos de GN
La compilación usa GN (Generate Ninja) con una configuración extensa:
gn_args = [ 'is_official_build=true', 'is_debug=false', 'symbol_level=0', # Toolchain 'clang_use_chrome_plugins=false', 'use_lld=true', 'use_custom_libcxx=false', # System libc++ # Disable Google services 'use_official_google_api_keys=false', 'enable_nacl=false', 'enable_widevine=false', # Hardware acceleration 'use_vaapi=true', 'use_v4l2_codec=false', # System libraries 'use_system_libffi=true', 'use_system_zlib=false', # ABI issues ...]
La decisión sobre use_custom_libcxx
CEF incluye por defecto su propia libc++ (use_custom_libcxx=true). Esto evita problemas de compatibilidad de ABI, pero:
Duplica una librería del sistema
Puede entrar en conflicto con aplicaciones que usan la libc++ del sistema
Aumenta el tamaño del binario
Después de muchas pruebas (compilaciones 108-140), use_custom_libcxx=false funciona con los parches de compatibilidad con C++23. Esta es la configuración preferida para la integración con Debian.
CEF requiere librerías de abstracción de GPU específicas:
ANGLE: implementación de OpenGL ES sobre Vulkan/DirectX. No es intercambiable con el EGL de Mesa: la API es parecida pero los internos difieren. Se instala en /usr/lib/x86_64-linux-gnu/cef/ con configuración de RPATH.
SwiftShader: implementación de Vulkan por software para sistemas sin aceleración de GPU. El JSON del ICD debe usar rutas absolutas:
CEF carga los recursos al principio de la inicialización, antes de la mayoría de los callbacks de la aplicación. La librería busca de forma relativa a libcef.so, no al binario de la aplicación.
La solución con enlaces simbólicos
# In /usr/lib/x86_64-linux-gnu/:icudtl.dat -> ../../share/cef/icudtl.datv8_context_snapshot.bin -> ../../share/cef/v8_context_snapshot.bin
Esto permite que los subprocesos (renderer, GPU, utility) encuentren los recursos cuando se lanzan con cef_execute_process(), antes de que se aplique ninguna configuración de la aplicación.
Pruebas y validación
Pruebas unitarias
CEF incluye ceftests, pero muchas pruebas requieren acceso a la red o una pantalla gráfica. El empaquetado ejecuta un subconjunto de las pruebas que funcionan sin conexión.
Pruebas de integración
La prueba definitiva es compilar una aplicación real. stremio-gtk ejercita:
Renderizado fuera de pantalla
Varios tipos de proceso
Protocolos de IPC
Aceleración de GPU
Carga de recursos
Problemas descubiertos a través de stremio-gtk que pasaron las pruebas unitarias:
Hacían falta enlaces simbólicos de recursos en el directorio de librerías
Las librerías de ANGLE eran obligatorias (no solo preferibles)
Las rutas del ICD de SwiftShader deben ser absolutas
El manejo de las opciones de línea de comandos de los subprocesos
Consideraciones de mantenimiento
Actualizaciones de Chromium
Cuando Debian actualiza Chromium, CEF debería seguirlo:
Obtener la rama de CEF que corresponda a la nueva versión de Chromium
Hacer rebase de debian/patches/chromium/ sobre las fuentes nuevas
Probar la compilación y resolver los nuevos conflictos
Actualizar los números de versión en todos los sitios
Actualizaciones de seguridad
CEF hereda la superficie de ataque de Chromium. Las actualizaciones de seguridad de Chromium deberían llegar a CEF con rapidez. La arquitectura de doble fuente ayuda: actualizar chromium_*.orig.tar.xz y recompilar cubre la mayoría de los problemas.
Coordinación con el fuente original
El fuente original de CEF responde bien a las preocupaciones de empaquetado. Varios parches desarrollados para Debian se han enviado al fuente original o han influido en sus decisiones.
Conclusión
Empaquetar CEF requiere tratar un motor de navegador como una librería, con toda la complejidad que eso implica. La arquitectura de doble fuente, la extensa pila de parches y la cuidadosa configuración de rutas producen paquetes que se integran con el ecosistema de Debian en lugar de luchar contra él.
El enfoque documentado aquí debería transferirse a otras distribuciones con políticas parecidas. Los parches están organizados por propósito (sistema de compilación, compatibilidad, rutas) para facilitar el porting.
Desde que publiqué la entrada anterior he estado usando la sesión de xfce en wayland en un par de máquinas y la verdad es que estoy muy contento con como va la cosa, así que me ha pillado un poco el tema y he seguido con un run run en la cabeza hasta que haciendo una búsqueda (no en google sino en apt) di con la respuesta.
El run run era una pregunta de si no había ningún "display manager" para wayland, es decir, sabía que el gdm iba nativamente sobre wayland, pero montar gdm con todas las dependencias que tiene para tener sólo un login... no me había molado, por eso comenté en el artículo anterior que podemos arrancar directamente el xfce en wayland desde el login de la consola. Pero claro... eso es un poco "cutre", igual no es esa la palabra pero me entendéis, hoy todo el mundo quiere todo gráfico, por eso tenemos en Debian un instalador gráfico que es igual que el de modo texto pero... es gráfico X-)
La pregunta que le hice a apt debió de ser algo como...
$ apt-cache search wayland display manager
greetd - minimal Wayland login manager
tan concreta fue su respuesta que no pude evitar instalar greetd y tirar del hilo, me llevó a que va a juego con los "greeters" y entre ellos me quedé con: nwg-hello - GTK3-based greeter for the greetd daemon
lo que pasa es que los greeters como nwg-hello necesitan por debajo un compositor, uno que me gustó mucho porque es muy sencillo y para un greeter va muy bien es cage, si queremos arrancar nwg-hello desde greetd usando cage tenemos que editar /etc/greetd/config.toml y poner command = /usr/bin/cage /usr/bin/nwg-hello
sencillo, ¿no?
Si te gusta el look explosivo que trae nwg-hello pues genial, yo lo quería un poco más sobrio y con el look de Debian, así que en /etc/nwg-hello hice lo que dice el README que está allí, copié los default y edité el nwg-hello.css para cambiar la imagen de fondo dejándola tal que así:
background-image: url("/usr/share/desktop-base/active-theme/login/background.svg"); background-size: 140% 140%
El cambio del tamaño a 140% es para que al agrandar la imagen el logo de Debian 13 se vaya más a la derecha y quede como al medio de la segunda mitad de la pantalla, donde no está la parte de login.
Puestos a investigar y dado que el compositor que uso luego en xfce es labwc me puse a buscar en la red si podíamos usar labwc para arrancar el nwg-hello y encontré esto donde se explica todo perfectamente, pero que resumiendo sería poner en /etc/greetd/config.toml: command = "labwc --config-dir /etc/nwg-hello/labwc-config"
y crear ese directorio que configuramos con esa linea, que no existe, y dentro de él creamos el fichero autostart con este contenido: exec /usr/bin/nwg-hello; /usr/bin/labwc --exit
y listo.
Ahora si que me ha quedado una sesión fully wayland y potita, y el overhead para la sesión es sólo el greetd, no se queda nada más por ahí corriendo, así que lo he puesto hasta en el netbook, aunque ahí hubo que tocar un poco más el css para que entrase todo en la pobre resolución de la pantalla, pero vamos, bajar los paddings de 12 a 5 y descomentar los labels del welcome y clock para que las fuentes sean más pequeñas.
Hace ya tiempo que quería pasar alguna de mis máquinas a Wayland pero nunca me ponía porque los entornos de escritorio que soportan Wayland son muy pesados y sway y sus amigos no me atraían mucho, la verdad.
Sin embargo recientemente, mientras probaba la que será la Debian 13 (Trixie, que todavía no ha salido, pero que ya ando probando), he tenido problemas con mi viejo netbook, y me vi probando algunas de las alternativas sobre Wayland y entre ellas y para mi sorpresa, en Trixie tendremos xfce 4.20, cuyo soporte de Wayland es todavía un poco pobre, pero que combinado con labwc creo que puede dar una buena experiencia sobre Wayland.
Vayamos al tema, tendremos que instalar los paquetes xfce4 labwc, eso está claro, añadimos algunos extras como xfce4-goodies xfce4-power-manager swayidle swaylock swaybg mako-notifier. La sesión de xfce para Wayland viene configurada ya en los paquetes y quedará disponible para su arranque desde los display managers (aunque ahora mismo parece que en lightdm no funciona, si lo hace en sddm y gdm3) o bien podemos arrancarla directamente desde la consola como se hacía antiguamente con las X con startx, como me recordó un viejo profile heredado desde sabe dios que versión de Debian que decía...
case "`tty`" in
    /dev/tty[1-4]) exec startx
esac
Pues como la sesión de xfce en wayland se arranca como startxfce4 --wayland podemos poner esto en lugar del startx o bien arrancarlo a mano, con un alias, ...
Uno de los primeros problemas que afronté fue la configuración de teclado, suelo usar teclado español y si bien encontré enseguida que la configuración que usa xfce para labwc está en el directorio .config/xfce4/labwc y en concreto podía poner el teclado en castellano poniendo en el fichero environment la variable XKB_DEFAULT_LAYOUT=es y ejecutando labwc -r para recargar, el problema está en que este fichero se genera automáticamente cada vez que se arranca xfce, así que se sobreescribía todo el rato, me costó bastante dar con este bug en el que se describe como workaround el crear un fichero con nombre lock en dicho directorio para evitar que xfce sobreescriba nuestra configuración.
Una vez conseguido esto empecé a configurar las cosas como a mi me gustan, normalmente haciendo todo ya desde la configuración gráfica de xfce, incluso cuando se trató de añadir el "salvapantallas" que bloquease la sesión al cabo de un rato indicando en la configuración de la sesión que quería ejecutar un nuevo programa con este comando que venía como ejemplo en alguna de las múltiples webs de ayuda de labwc:
Una cosa más, que sí tuve que tocar a mano, porque la parte del teclado va todo sobre labwc, fueron los atajos de teclado, los keybindings que se definen en .config/xfce4/labwc/rc.xml y que quería cambiar para añadir un atajo a la ejecución de comandos con control+alt+espacio usando:
Básicamente eso fue todo, para estar por así decirlo en pañales esta primera versión de xfce con soporte de wayland... la verdad, todo bastante bien, sobre todo la economía de memoria de todo esto corriendo en mi viejo netbook con 2 gigas de ram ahorrándome display managers y todo tipo de cosas que no necesitaba para nada, mucho mejor que mi viejo setup que ya era minimalista, pero llevaba las X con su display manager, ... ahora no voy a decir aquello de que "es alucinante y vuela" ;-) porque ya sabemos que ese viejo Atom con un navegador moderno nunca va a volar, pero... va mucho mejor :-)
Entre los requirimientos de Windows 11 están una CPU moderna, arranque EFI seguro y un dispositivo de seguridad TPM versión 2.0. A continuación os comentaré como lo instalé sin trucos en una máquina virtual dentro de una máquina que no tiene ni TPM ni arranque seguro EFI, así que el único requerimiento que cumplía era el tener una CPU algo moderna, con virtualización hardware, claro.
Para poder probar cosas con el Windows 11 en el trabajo he querido instalar Windows 11 como siempre hago con los Windows, es decir, en una máquina virtual dentro del sobremesa, hasta ahora siempre lo he hecho con VirtualBox, es cómodo y cumplía con lo que yo necesito.
Sin embargo en este caso, si queremos instalar Windows 11 sin trucos, necesitaremos un dispositivo de seguridad TPM, que no existe en VirtualBox, así que... he explorado un poco el mundo de libvirt usando por debajo KVM, que sí que nos permite usar un TPM software y el resto de cosas que necesita Windows 11 para funcionar.
He utilizado los paquetes de Bookworm (ahora en testing mientras no se convierte en la nueva estable) para contar con las últimas versiones y no tener que andar haciendo las cosas "a mano" editando los XML y tal, con las versiones de Bookworm se puede hacer todo en plan gráfico sin problema, con versiones anteriores igual también se puede, pero en algunas hay que tocar los XML a mano.
La cosa para mi ha sido instalar por un lado la parte de libvirt, instalé estos paquetes: virt-manager virt-viewer libvirt-daemon-driver-qemu libvirt-daemon-system libvirt-daemon-system-systemd libvirt-daemon-config-nwfilter libvirt-daemon-config-network libvirt-clients gir1.2-spiceclientgtk-3.0
Por otro lado para cumplir con los requerimientos del Windows 11 (TPM y arranque EFI) instalé: swtpm-tools ovmf
En algunas pruebas en alguna máquina muy "barebones" no tenía un polkit adecuado así que le instalé: lxpolkit Esto no será necesario en sistemas normales con interfaz gráfica ya que ya tendrán instalado un polkit, sino... el propio virt-manager os lo indicará con un error, sino... arrancarlo con "--debug"
Entre los requerimientos de Windows 11 están la CPU, que tiene que ser moderna y que el arranque sea EFI, por ello definiremos una nueva máquina en el virt-manager poniendo de arranque la ISO del Windows descargada de MS, dejaremos que detecte el operativo (detecta Windows 10, por ahora no tienen 11, pero nos sirve) y justo al final, antes de darle a finish, activaremos "Customize configuration before install" y ahí le ponemos en "overview" tendremos que cambiar el apartado "firmware" de BIOS a UEFI con arranque seguro (secboot), además iremos a la ventana "CPUs" y eligiremos en "Configuration" la opción "host-passthrough".
Si le dimos a "apply" en las opciones podemos volver a "overview" y comprobar en el xml que nos queda algo como esto:
machine=pc-q35-7.1
cpu mode='host-passthrough'
...
firmware UEFI x86_64: /usr/share/OVMF/OVMF_CODE_4M.secboot.fd
El otro requerimiento que tiene Windows 11 y que no suelen cumplir las máquinas menos modernas es el TPM, pero al ser una máquina virtual usamos el TPM software que hemos instalado y listo. Para esto añadimos a la máquina un dispositivo nuevo de tipo TPM y modelo TIS, y listo, ya podemos darle a "Begin installation".
Esta configuración de máquina es con la tarjeta gráfica qxl, cuando terminemos la instalación de Windows será conveniente instalar en el Windows 11 las spice guest tools que podemos descargar de spice-space.org para tener un buen soporte del esta y el resto del hardware.
Una vez instalemos eso apagamos la máquina y en el virtual-manager en la ventana de la máquina virtual Windows 11, seleccionamos "view", "scale display" y marcamos "autoresize vm with window"
Listo, con esto Windows debería reconocer todo el hardware y hacer escalado de la pantalla al tamaño de nuestra ventana.
La situación actual nos ha llevado a muchos a trabajar en remoto, algo para lo que hay muchas opciones, hablemos de alguna de ellas.
SSH
Es el sistema de acceso remoto por excelencia, lo usamos todos desde siempre, o al menos desde que la seguridad en la red importa, aunque no siempre fuera así, los ancianos del lugar usábamos el telnet, pero mejor no hablar de temeridades, no? ;-)
El secure shell como su propio nombre indica está diseñado para acceder a un shell, es decir, para acceso remoto a un entorno modo texto, pero como ya sabréis permite hacer túneles de todo tipo, desde puertos hasta forwarding de clientes X.
Si bien el SSH nos permite acceder a nuestros clientes X y traerlos hasta el servidor local de nuestro ordenador en casa, resulta que las X no están diseñadas para que el cliente y el servidor estén separados por las latencias de una wan por medio, por lo que aunque tengamos 1 giga de ancho de banda, nuestras aplicaciones X en remoto irán muy lentas, por eso... veamos que podemos utilizar para la parte gráfica...
x2go
Seguro que es el sistema más currado y más complejo para acceso remoto, soporta no sólo Linux, pero... si lo probáis veréis que hace muchas cosas por su cuenta sin contárnoslas, así que uno no deja de preguntarse... ¿para qué es todo esto? Lo tenemos soportado en Debian con paquetes tanto para hacer de servidor como para cliente, aunque ya os digo que a mi me pareció demasiado complejo y poco transparente.
Sin embargo si miramos debajo del capó vemos que utiliza la tecnología de NX que me parece más sencilla y entendible.
NX
Se trata de una tecnología que nos permitirá la utilización de aplicaciones nativas X tal cual, se basa en la proxificación de los clientes X de modo que los eventos no tengan tanta latencia y por lo tanto todo vaya mucho más fluido. Además añadiremos un servidor X en el lado remoto que nos permitirá tener una mejor respuesta y sesiones permanentes.
Su uso es sencillo, veamos un ejemplo, la idea es que accedemos al sistema remoto via ssh -L 4008:localhost:4008 host.remoto (forwardeamos el puerto 4008 que usaremos para el proxy de NX que correremos con :8 o sea usando el puerto 4008) y allí ejecutamos un proxy al que nos conectamos desde localhost a través de este puerto que hemos forwardeado. Esa es la parte de proxificado, pero vamos a añadir el agente que lo que hace es añadir un servidor X local sobre que lanzaremos las aplicaciones X y que nos dará también una sesión permanente que nos permite desconectarnos y conectarnos cuando queramos, veamos esto:
En el ejemplo arrancamos el lxqt, pero se puede arrancar lo que sea. Esta sesión sera permanente, ya que como dijimos estamos arrancando un servidor X en el equipo remoto, en este caso el DISPLAY será :9, contra el que irán las aplicaciones X. Aunque apaguemos el equipo local, se corten las comunicaciones o lo que sea, podremos reconectar. Para esto sólo hay que rearrancar las partes del proxy remoto y local y luego avisar al nxagent de que queremos que nos vuelva a mandar el display utilizando por ejemplo:
killall nxagent -HUP
VNC
Que decir de VNC, ha estado ahí desde hace muchos años.
Tenemos el servidor al estilo windows, en el paquete x11vnc que podemos arrancar así:
x11vnc -rfbport 5900 -bg -o %HOME/.vnc/x11vnc.log.%VNCDISPLAY -rfbauth ~/.vnc/passwd -display :0
o el tigervnc-scraping-server que al igual que el anterior nos permitirá acceder vía cliente VNC a unas X que estén corriendo, aunque ahora tenemos también la extensión de X tigervnc-xorg-extension que nos dará la misma funcionalidad pero de una manera mucho más eficiente. Estos están bien para ver lo que hay en ejecución en la pantalla de un equipo y por ejemplo ofrecer ayuda remota.
Además tenemos el tigervnc-standalone-server y el tightvncserver que lo que nos permiten es tener todas las sesiones X que queramos (ya que no van atadas a nuestra gráfica ni nada) y accederlas en remoto vía VNC, y por supuesto varios clientes específicos de vnc como tigervnc-viewer y xtightvncviewer además de otros que soportan VNC y otros protocolos.
El handicap de siempre del VNC es que todo va en claro, nada va cifrado, así que necesita sí o sí de SSH o similar para cifrar los datos.
RDP
Este protocolo diseñado por Microsoft tiene ahora tanto servidores como clientes para Linux, requiere mucho menos ancho de banda que VNC y soporta diversos tipos de cifrado, tanto cifrado propio como incluso una capa de TLS.
Al igual que en el caso de VNC tenemos también servidores para acceso a un servidor X ya existente, como el freerdp-shadow-cli en el paquete freerdp2-shadow-x11. Lo podemos lanzar con esta orden para acceder a las X corriendo en :0:
DISPLAY=:0 freerdp-shadow-cli /port:12345
Ya sabéis, como en el caso del VNC, es muy útil para ayuda remota. Si bien es conveniente tener en cuenta este bug ya que hace que nofuncione la autenticación mientras que no lo arreglemos, así que o bien recompilamos o bien añadimos el parámetro -auth, pero entonces cualquiera que tenga acceso al puerto podrá tomar control de la sesión X.
También tenemos clientes como el clásico rdesktop o el xfreerdp del paquete freerdp2-x11 y otros clientes que soportan VNC, RDP y más, como vinagre, de GNOME o remmina.
Pero si lo que queremos es un acceso remoto a un entorno de trabajo Linux persistente tendremos que fijarnos en xrdp, todo un servidor rdp para dar acceso a tantas sesiones de escritorios Linux como queramos, estas sesiones serán permanentes y podremos conectarnos y desconectarnos de las mismas cuando queramos, además soporta sonido, aunque eso requerirá que compilemos los módulos siguiendo estas instrucciones, la reproducción de sonido es estándar, por lo que funcionará en cualquier cliente, pero si queremos mandar nuestro micro al server deberemos utilizar por ejemplo el paquete de rdesktop de buster (lo he probado y funciona) o algún otro compatible, ya que han hecho una implementación no estándar :-(
No voy a hablar de más protocolos (que los hay) pero si quería hablar de algo que me parece muy interesante, un potente cliente web de todos estos protocolos y más...
Guacamole
Esto si que no lo tenemos en Debian, aunque hubo algún intento de paquetización antiguo y probablemente os podáis encontrar todavía por ahí los paquetes viejos, no os los aconsejo porque tienen varios bugs de seguridad. Este cliente es bastante complejo, con diversas partes, basado en java, requiere al menos un tomcat para mover el servidor, ... pero a cambio tendremos acceso a servidores RDP, VNC, ssh, ... con seguridad de dos factores en varios estilos y colores y el cliente no necesitará nada más que un navegador web, algo que nos puede aligerar los requisitos para los trabajadores que tengan que acceder en remoto.
Bueno, eso es todo lo que se ocurre ahora mismo, podéis sugerir otras ideas en los comentarios.
Una vez configurados Prosody y Jicofo, el siguiente elemento (y último necesario para usar Jitsi Meet) será el Videobridge. El Videobridge es un Selective Forwarding Unit (SFU), esto significa que no hace ningún tipo de procesamiento de los flujos de vídeo, simplemente recoje el vídeo de cada participante y lo hace llegar al resto. Esto se traduce en:
Gran uso de ancho de banda, cada señal de vídeo que llega debe ser multiplicada por el número de participantes (menos uno, su origen). Si tenemos 5 participantes con cámaras activas, pongamos a 500kbps cada flujo. Tendremos 2.5Mbps de entrada en el videobrige y casi 10Mbps de salida de éste a los clientes. Podemos limitar este tráfico a los clientes con el parámetro channelLastN en la configuración de Jitsi Meet que comentaré más adelante, aliviando la carga en los navegadores.
Uso comedido de RAM y CPU. Al no tener que procesar los vídeos, el uso de estos recursos no es alto. Para conferencias con menos de 30-40 participantes, y un número razonable de cámaras abiertas, 1-2 cores y 2-3GB de RAM serán suficientes. Atención: por defecto el Videobridge podría reclamar hasta 3GB de RAM. Podemos limitar esa cantidad (si tenemos menos de 4GB de RAM) usando el parámetro VIDEOBRIDGE_MAX_MEMORY=XXXXm con los megas que queramos, por defecto 3072m, en el fichero /etc/jitsi/videobridge/config.
Dicho esto, podemos correr tantos Videobridge como deseemos, lo que permite escalar en horizontal. Podemos partir de un Videobridge en la misma máquina que Prosody y Jicofo, o dejar éstos en un servidor (con muy pocos requisitos de memoria y CPU) y luego ir añadiendo máquinas con Videobridge.
Configuración de un Videobridge
Al igual que pasaba con Jicofo, tenemos dos ficheros principales de configuración para un Videobridge. De hecho, hay información redundante en ellos. El motivo es que existen varios mecanismos de comunicación (APIs) de los Videobridge con el mundo exterior. Hasta no hace mucho la conexión entre Videobridge y Prosody se hacía registrando el Videobridge como un componente (servicio) en Prosody. Hoy la preferencia es el uso de MUCs (canales). Y de ahí los rastros que van quedando por su configuración.
Empecemos por /etc/jitsi/videobridge/config, donde encontramos parámetros de arranque del proceso y configuración de XMPP como componente:
El primer grupo de opciones no serían necesarias si no registramos Videobridge como componente. No hay mucho que explicar de ellas y la tendencia del proyecto es usar MUCs.
Si es digna de mención la opción JVB_OPTS. En versiones actuales lleva el valor "--apis=,", que levantará el cliente XMPP (como usuario normal, no componente) por defecto. Antiguamente era necesario especificarlo (con el valor xmpp). También podemos activar un API REST u otro llamado Colibri del que se pueden sacar estadísticas del Videobridge. Por eso es frecuente ver en documentación no muy actual el valor "--apis=rest,xmpp". Salvo que queramos el API REST activo, no es necesario modificar esta variable. Por el MUC, que ahora configuraremos, también se obtienen estadísticas del Videobridge e incluso hay un exportador para prometheus que usa este mecanismo.
El fichero en el que realmente hay que configurar Videobridge en sus versiones más modernas (videobridge2) es /etc/jitsi/videobridge/sip-communicator.properties:
Las dos primeras opciones (DISABLE_AWS_HARVESTER y STUN_MAPPING_HARVESTER_ADDRESSES) están relacionada con el protocolo ICE desarrollado por Jitsi y que sirve para gestionar las conexiones que atraviesan NAT. La primera no es relevante salvo que tengamos el servidor en AWS y la segunda deberemos especificarla si nuestro videobridge está detrás de algún NAT (es decir, no tiene una IP pública pero se usará con clientes de fuera de su red local). El servidor especificado en este ejemplo (meet-jit-si-turnrelay.jitsi.net:443) es el que pone la configuración del paquete, pero podríamos usar uno bajo nuestro control para no depender de este servicio externo.
A continuación vienen tres opciones (ENABLE_STATISTICS, STATISTICS_TRANSPORT y STATISTICS_INTERVAL) que indican que queremos las estadísticas, y con que frecuencia (en milisegundos) por el MUC de comunicación con Jicofo. Estas, además de poder exportarse a Prometheus u otra herramienta, permiten que Jicofo tenga conocimiento de la carga en cada uno de los Videobridges permitiendo que balancee correctamente las nuevas conferencias entre ellos.
Luego tenemos toda la configuración del Videobridge como cliente XMPP. La opción HOSTNAME apuntará al servidor XMPP y podrá ser localhost si corre en la misma máquina o tener la IP o nombre de la máquina donde se encuentre Prosody. DOMAIN indica el Virtualhost de Prosody donde se autentican los elementos que conforman Jitsi Meet, normalmente auth.DOMINIO_PRINCIPAL. USERNAME y PASSWORD son las credenciales para registrarse en Prosody, recordar que hay que crear el usuario como vimos anteriormente. Varios, o todos, los videobridge pueden usar el mismo USERNAME y PASSWORD, y la opción MUC_NICKNAME permitirá diferenciarlos posteriormente. Así que podemos crear un usuario por videobridge y usar el mismo nombre como nick, o crear un sólo usuario y que cada videobridge use un nick diferente. Esto último facilitaría la configuración de nuevos videobridge (no sería necesario crear un usuario en Prosody por cada uno). MUC_JIDS indica el nombre del canal (lospuentes) y el componente de MUC (internal.auth.EXAMPLE.NET) donde se comunicaran los videobridges con Jicofo, así que atención a que sea el mismo en Jicofo y todos los videobridge. La última opción importante en esta sección es AUTHORIZED_SOURCE_REGEXP, que indica de donde puede recibir órdenes en videobridge. Cuidado con esta opción, porque una expresión regular errónea no permitiría la creación de conferencias en el videobridge. Casi toda la documentación hasta ahora ponía como ejemplo algo tipo: focus@auth.EXAMPLE.NET./.* Esta sintáxis sólo es válida si se usan componentes XMPP. Ya no es correcta con el uso de MUCs, pese a no estar muy documentado (esto es todo lo que encontré al respecto), y deberemos usar la sintaxis: lospuentes@internal.auth.EXAMPLE.NET/focus.*$, donde lospuentes es el ya sabido nombre del canal, internal.auth.EXAMPLE.NET es el nombre del componente MUC y focus es el nick de Jicofo en XMPP.
Para terminar con la configuración del cliente XMPP del videobride, la opción DISABLE_CERTIFICATE_VALIDATION, como su nombre indica, permite desactivar la validación del certificado SSL que presenta Prosody. Como ya comenté, la instalación del paquete jitsi-meet-prosody, crear unos certificados autofirmados para el dominio auth.DOMINIO_PRINCIPAL. Si no queremos copiar dichos certificados en los videbridge, y su conexión al Prosody es local, podemos usar esta opción para ahorrarnos la tarea.
Con esto terminamos la configuración del videobridge. Para probarlo por completo recomiento una conferencia con al menos tres participantes. El motivo es que con 2 participantes el videobridge «no es realmente necesario», el vídeo irá entre los participantes directamente. Sólo la entrada de un tercer usuario hará que el videbridge se ponga a trabajar de verdad. Y es en ese momento, la entrada del tercero, cuando veremos si está todo OK. Si al entrar el tercer participante las imágenes de todos quedan en negro, hay algo mal configurado. Revisad el log del Videobridge (/var/log/jitsi/jvb.log) y de Jicofo (/var/log/jitsi/jicofo.log) en busca de problemas de comunicación entre ellos. En el del videobrige deberíamos ver algo como:
2020-05-20 12:33:34.980 INFO: [20] [hostname=localhost id=shard] MucClient$MucWrapper.join#751: Joined MUC: lospuentes@internal.auth.EXAMPLE.NET
# Seguido (si habilitamos las estadísticas) de estos:
2020-05-20 12:35:54.636 INFO: [19] AbstractHealthCheckService.run#171: Performed a successful health check
En el de Jicofo, a la entrada del Videobridge, veremos:
org.jitsi.jicofo.bridge.BridgeSelector.log() Added new videobridge: Bridge[jid=lospuentes@internal.auth.EXAMPLE.NET/JVB_NICK, relayId=null, region=null, stress=0.00]
En caso de no verse esta línea «Added new videobridge«, revisa que el nombre del canal sea igual en ambos (Jicofo y videobridge) y que el videobridge se está registrando («Joined MUC«) correctamente. Si todo va correctamente, ya tienes la base. En próximas entradas hablaré del front-end web (Jitsi Meet), Jibri y los famosos tokens.
Una vez tenemos configurado el servidor XMPP, con o sin autenticación, veamos el siguiente componente a configurar: Jicofo. Encargado de repartir las conferencias entre los videobridges disponibles, podemos decir que, junto con Prosody, Jicofo es la pieza central de la arquitectura Jitsi Meet. Además ambas son bastante ligeras y pueden correr juntas, junto con nginx y Jitsi Meet (el cliente web), en una máquina con una CPU y poco más de 1GB de RAM.
Configuración de Jitsi Conference Focus(Jicofo)
Jicofo tiene dos ficheros principales de configuración. El primero, /etc/jitsi/jicofo/config, lleva las opciones que se pasan al demonio en su ejecución (JAVA_SYS_PROP y JICOFO_OPTS) y las de autenticación de Jicofo en Prosody. Son estas últimas las que normalmente tocaremos (o tocará el paquete Debian en su instalación). Se trata de:
JICOFO_HOST, yo hubiera usado otro nombre para esta variable, es el servidor XMPP al que se conectará Jicofo. «localhost» será el valor de esta variable si ejecutamos Prosody en la misma máquina que Jicofo. En otro caso será el nombre o IP del servidor Prosody y, salvo que uses en Prosody un certificado SSL válido universalmente, tendrás que copiar los certificados de Prosody para tu dominio (normalmente en /var/lib/prosody/EXAMPLE.NET.crt y auth.EXAMPLE.NET.crt) al directorio /usr/local/share/ca-certificates/ del servidor con Jicofo y ejecutar update-ca-certificates en él para que sea reconocido por Jicofo.
Jicofo se registra, a día de hoy, de dos maneras en el servidor XMPP:
1.- Como un usuario normal. Cuyos datos son JICOFO_AUTH_DOMAIN, el dominio donde se registran todos los componentes (auth.EXAMPLE.NET), JICOFO_AUTH_USER y JICOFO_AUTH_PASSWORD. Estos datos, así como la creación del usuario en Prosody, suelen cumplimentarse por la instalación del paquete Debian. Si lo haces manualmente, puedes comprobar que son correctos, o crearlos como se indica, en el directorio de usuarios de Prosody. Si decidieras cambiar el nombre de usuario, «focus» por defecto, ten en cuenta que es el administrador de algunos componentes en Prosody y tendrás que corregir esa configuración.
2.- Como un «componente», un servicio dentro del propio servidor XMPP. El nombre del servicio será focus.EXAMPLE.NET (no confundir con el usuario: focus.auth.EXAMPLE.NET). Los datos de este registro son JICOFO_HOSTNAME (al que añadirá focus. para el nombre del servicio) y JICOFO_SECRET. Que deberán de coincidir con la configuración en Prosody:
El segundo de los ficheros de configuración, /etc/jitsi/jicofo/sip-communicator.properties, indica el nombre «del canal» o sala donde se reunirán los diferentes componentes (videobridges y Jibris):
org.jitsi.jicofo.BRIDGE_MUC=lospuentes@internal.auth.EXAMPLE.NET
# OPCIONALES, sólo si se usan Jibris:
org.jitsi.jicofo.jibri.BREWERY=losgrabadores@internal.auth.EXAMPLE.NET
org.jitsi.jicofo.jibri.PENDING_TIMEOUT=90
internal.auth.EXAMPLE.NET es un componente MUC (Multi-User Chat) de Prosody que ya vimos. Cuando configuremos los videobridges y Jibris, deberemos indicar estos nombres de canales en su configuración, sólo así sabrá Jicofo de su existencia.
Una nota importante. Como podréis deducir de quién se registra dónde, es importante el orden en el que se arrancan (o reinician en caso de cambios de configuración) los servicios. El primero en arrancar debe ser Prosody, seguido de Jicofo y por último el resto de componentes. De no hacerlo así se pueden sufrir comportamientos extraños.
Posiblemente uno de los motivos de mayor peso para instalar una instancia propia de Jitsi Meet es poder controlar/limitar quien accede a ella. Veremos en este artículo como requerir autenticación a los usuarios que se conectan usando LDAP para ello.
Autenticación de usuarios con LDAP (PAM, SQL, …)
Existen varias alternativas para la autenticación de usuarios con LDAP: mod_auth_ldap, mod_auth_ldap2 y el elegido por Jitsi en su paquetería: cyrus. Cyrus es una implementación del estándar SASL que abstrae el servicio de autenticación (LDAP en este caso) del consumidor del mismo (Prosody), por lo que en realidad usando SASL podríamos usar cualquier tipo de «backend» para validar usuarios (PAM, SQL,…). Los cambios necesarios en la configuración de nuestro VirtualHost principal (EXAMPLE.NET) serían:
Donde dice:
authentication = "anonymous"
Dirá:
authentication = "cyrus"
cyrus_application_name = "xmpp"allow_unencrypted_plain_auth = true
Además añadiremos está línea en el bloque "modules_enabled":
"auth_cyrus";
La opción cyrus_application_name indicará la configuración a usar por saslauthd para autenticar los usuarios. Mientras que la opción allow_unencrypted_plain_auth = true permite un mecanismo de autenticación inseguro (claves en claro) que sospecho es necesaria para dar soporte al cliente (javascript) de Jitsi Meet que no soporta otros mecanismos SASL como CRAM-MD5 o GSSAPI. Si configurasteis c2s_require_encryption = true, no debería ser un problema. En otro caso podrían viajar contraseñas en claro entre el servidor web y Prosody.
Lo siguiente será configurar saslauthd para prestar servicio a Prosody. Para ello instalaremos los siguientes paquetes (o sus correspondientes en distribuciones no Debian):
En el fichero de configuración de arranque de saslauthd (/etc/default/saslauthd) activaremos el arranque y configuraremos LDAP como «backend» para la autenticación:
START=yes
MECHANISMS="ldap"
Luego editaremos la configuración LDAP del saslauthd (/etc/saslauthd.conf). Por ejemplo para usar Autenticación Simple (conectar con el servidor LDAP usando las credenciales proporcionadas por el cliente):
Por último crearemos el fichero de configuración SASL para el servicio xmpp, el nombre de este fichero debe coincidir con el especificado en Prosody como cyrus_application_name. En este caso será /etc/sasl/xmpp.conf y su contenido será:
pwcheck_method: saslauthd
mech_list: PLAIN
Además debemos añadir al usuario prosody en el grupo sasl para que tenga acceso al socket de comunicación con el demonio saslauthd (en /run/saslauthd/):
# adduser prosody sasl
Después de editar todos estos ficheros será necesario reiniciar tanto Prosody como saslauthd:
Antes de seguir, os recomiendo que probéis al menos el funcionamiento de saslauthd para que en caso de problemas de autenticación podamos descartar esa parte. Un simple comando valdrá:
Sí, lo sé… contraseñas en línea de comando. No hay nada perfecto. Si pasamos la prueba, podemos seguir con la configuración.
Desde este momento, todos los usuarios tendrán que autenticarse para unirse a una conferencia. Pero es posible que también deseemos que usuarios anónimos se unan (a una sala creada), dejando la autenticación como requisito para crear una sala nueva y dar privilegios de moderador.
Dejar unirse, como invitados, a usuarios no autenticados (Secure Domain)
Tendremos hacer unos cambios en Jitsi Meet, Prosody y Jicofo para que los usuarios anónimos entren bajo un Virtualhost diferente en Prosody. Empezando por Prosody, añadiremos lo siguiente a nuestro fichero de configuración:
Como vemos, en este Virtualhost no hay autenticación. Luego habrá que informar a Jitsi Meet de este dominio para los usuarios que no se autentican. En su fichero de configuración (/etc/jitsi/meet/EXAMPLE.NET-config.js):
# Descomentar la siguiente línea:
anonymousdomain: 'invitados.EXAMPLE.NET',
Por último habrá que decirte a Jicofo (encargado de la creación de salas) que sólo los usuarios de nuestro dominio con autenticación pueden crear salas/ser moderadores. En /etc/jitsi/jicofo/sip-communicator.properties:
# Añadir la línea
org.jitsi.jicofo.auth.URL=XMPP:EXAMPLE.NET
No olvidéis reiniciar Prosody y Jicofo después de todos estos cambios. En próximas entregas hablaré de la configuración del resto de componentes y de la autenticación con tokens, que permite una integración con aplicaciones de terceros como Moodle. $ exit
Una vez conocidos los componentes, veremos ahora la configuración de los mismos. Mi objetivo no es tanto dar unas instrucciones paso a paso, sino explicar que partes de la configuración sirven para qué propósito y qué opciones tenemos en función de las características que deseemos en nuestra instalación.
Prosody (autenticación de usuarios y componentes Jitsi)
Los paquetes Debian que proporciona el proyecto Jitsi crean un fichero de configuración con todo lo relacionado con Jitsi. Esto permite evitar cambios en el fichero principal y aislar la configuración propia de Jitsi de otra configuración que ya pudiéramos tener en Prosody. Entiendo, por tanto, que tendremos un fichero /etc/prosody/conf.avail/EXAMPLE.NET.cfg.lua y que habrá un enlace simbólico a este fichero desde /etc/prosody/conf.d/EXAMPLE.NET.cfg.lua. Donde EXAMPLE.NET será el dominio de nuestra instalación (p.e. meet.inittab.org).
La (falta de) autenticación de usuarios
Como ya hemos comentado, Prosody es el encargado de la autenticación de usuarios. Ésta se configura en un VirtualHost que llevará por nombre el mismo que nuestro dominio. El siguiente ejemplo permite la entrada de cualquier usuario en nuestro Jitsi Meet, es decir no realiza autenticación de usuarios:
Antes de ver las opciones de autenticación, quería hacer dos puntualizaciones sobre la configuración creada por el paquete «jitsi-meet-prosody«. Éste genera una clave y certificado autofirmado (los que están en /etc/prosody/certs) y deshabilita la obligación de usar TLS en las conexiones de clientes (c2s_require_encryption = false). Aunque pueda parecer inseguro, la realidad es que nuestras credenciales ya viajan seguras por la conexión HTTPS con el servidor web. Si quisiéramos cubrir el tramo entre nuestro servidor web y Prosody, podríamos configurar un certificado válido, por ejemplo de Let’s Encrypt y activar (true) la opción c2s_require_encryption:
En él vemos que focus@auth.EXAMPLE.NET, el usuario que usa Jicofo, será el administrador de las salas. Este bloque será modificado cuando usemos autenticación con «tokens» para gestionar los moderadores y participantes en las salas.
Otro bloque similar es el que usan los diferentes componentes de Jitsi Meet para comunicarse entre ellos (informar de que videobridges y jibris están disponibles y cual es su carga para que Jicofo decida en qué videobridge crear nuevas salas o qué Jibri se encargará de una petición nueva de grabación):
También vemos que el usuario de Jicofo es el administrador de este muc. Los usuarios de los componentes de Jitsi Meet no se autentican en el dominio principal (EXAMPLE.NET) sino en uno propio (auth.EXAMPLE.NET). Esto permite que podamos cambiar la configuración de autenticación para los asistentes, en el dominio principal, sin afectar a la autenticación de los componentes, que se hace en el dominio auth.EXAMPLE.NET:
Una vez más vemos que los certificados usados para este VirtualHost son autofirmados y creados por la instalación del paquete «jitsi-meet-prosody«. Si bien este dominio no tiene por qué existir en el DNS, y por tanto no disponer de un certificado válido, si será necesaria la propagación del certificado (en los directorios /usr/local/share/ca-certificates) a los servidores adicionales a éste que ejecuten videobridges, jibris o jigasi si queremos que verifiquen la identidad del servidor Prosody cuando se autentiquen en él. De otra manera tendremos que usar una opción en ellos para deshabilitar la comprobación de este certificado (TODO: aquí vendrá el enlace a esa opción cuando esté su artículo).
La autenticación en este VirtualHost, authentication = "internal_plain", se realiza de forma local por Prosody. Por este motivo los usuarios de los componentes deben ser dados de alta con la herramienta prosodyctl. Para los componentes instalados en el mismo servidor que Prosody, esto se hace automáticamente por la paquetería de Debian. Pero si instalamos componentes en otros servidores deberemos hacerlo nosotros manualmente. Veamos como.
Prosody mantiene un directorio por cada VirtualHost que tiene autenticación "internal_plain", en nuestro caso (auth.EXAMPLE.NET) podemos verlo así:
En el nombre del directorio (y en los ficheros que contenga) se codifican, en código porciento, los caracteres especiales como puntos o guiones. Por eso el nombre «feo» del directorio. Dentro de él vemos un fichero con cada usuario registrado en este VirtualHost. Para dar de alta un usuario, para un componente nuevo, usaremos el siguiente comando:
Queda alguna configuración más que comentar, para usuarios invitados cuando usemos autenticación de participantes, o para la autenticación especial de Jibris, pero la veremos más adelante.
Con este artículo espero que se entienda, más o menos, el papel de Prosody uniendo el resto de piezas y las posibilidades de «fortificarlo» más de querer ser extrictos con la seguridad. En el próximos artículos veremos la autenticación de usuarios mediante LDAP.
Aprovecho para recordaros que en el Playbook de Ansible de la UDIMA para Jitsi Meet todas las tareas de instalación y configuración están automatizadas y casi podríais ahorraros leer estos peñazos que escribo $ exit
Últimamente parece que las videoconferencias se han puesto de moda, como el papel higiénico. Y si bien hay muchas alternativas, la inmensa mayoría podrían no respetar tu privacidad y algunas tienen un historial de problemas de seguridad que asusta.
Por suerte hay una alternativa plenamente funcional y libre: Jitsi Meet.
No necesitas nada para usar Jitsi Meet*
* Salvo un navegador actual o su aplicación móvil/de escritorio
Si no tienes medios (servidor, ancho de banda, ganas de complicarte la vida), puedes usar su servicio público que funciona estupendamente. Es muy sencillo, simplemente dale un nombre a tu conferencia y pasa la URL resultante (por ejemplo: https://meet.jit.si/UnPingüino) a todos los participantes que quieras invitar.
Evita, eso sí, nombres fáciles o comunes («pepe», «prueba», «test») para la conferencia o puede que entre más gente de la que esperas, ya que las conferencias en el servidor público no limitan quien entra en ellas.
Pero si lo que quieres es no depender de terceros, controlar quien puede entrar en tus conferencias, o proteger tu privacidad, puedes instalar Jitsi Meet en un servidor propio. Y a eso es a lo que hemos venido.
Las piezas del puzzle
Nada es perfecto, y si en algo peca(ba) Jitsi Meet es en su documentación. Tal era la situación que salió un proyecto paralelo sólo para documentarlo: EasyJitsi Os recomiendo echarle un ojo para tener más información.
Lo primero que debemos hacer antes de montar Jitsi Meet es entender que piezas lo componen y para que sirven cada una de ellas.
Prosody
Aunque no es parte del proyecto Jitsi, Prosody es una de las piezas más importantes de esta arquitectura. Se trata de un servidor XMPP. O en términos más claros; un servidor de mensajería instantánea. XMPP es un grupo de protocolos que definen y permiten todas las características esperables en un servicio de mensajería: autenticación de usuarios, conversaciones con varios participantes (rooms/canales), envío de ficheros, … Es el protocolo sobre el que se construye Google Talk / Hangouts / Chat, aunque Google decidiera no usar el estándar para interoperar con otras implementaciones XMPP. Pero tranquilos, con más de 1.500 millones de usuarios de Gmail pronto tampoco tendrá que intercambiar correo con nadie que no sean ellos y podrá inventarse las extensiones que lo mejoren y liberen de viejos estándares. ¡Hala!, ya me despaché. Sigamos…
Prosody será el encargado de autenticar al resto de componentes de Jitsi Meet y, en caso de quererlo, a los usuarios que se conecten a nuestro servicio de Meet. Además gestiona la comunicación entre componentes y usuarios. Por ejemplo permitiendo que Jicofo sepa de la existencia de videobridges y Jibris en servicio.
Jicofo (Jitsi Conferenre Focus)
Es el encargado de dirigir la orquesta. Lleva el control de los recursos, decide en que videobridge se hospeda una conferencia (en función de la carga de los disponibles) o que Jibri será el que transmitirá (a Youtube, por ejemplo) o grabará la sala que lo así solicite.
Videobride
Es el encargado de recibir y hacer llegar los flujos de audio y vídeo a los participantes de una conferencia. Aunque en una conferencia de dos personas es posible que los vídeos vayan de un a otro participante directamente, sin mediar el videobridge, en cuanto los participantes son tres o más, todos envían su señal de vídeo al videobridge, que la repite al resto de participantes.
Este funcionamiento es además característica fundamental de Jitsi Meet. Los videobridge no mezclan vídeo, según llega de un cliente sale al resto. Eso se traduce en menos latencia, al no perder tiempo procesando vídeo, a costa de un uso alto (con muchos participantes) de ancho de banda. Por ejemplo, y dependiendo de la calidad que usemos, si tenemos 10 participantes, con la cámara abierta, enviando vídeo a 3Mbps, además de estar recibiendo 30Mbps estaría sacando unos 300Mbps de tráfico.
Jibri (Jitsi BRoadcasting Infrastructure)
Permite grabar, en disco o nube, o retransmitir a Youtube (por ahora) una sesión. Está compuesto por varios componentes: el propio Jibri que se conecta con prosody para recibir las órdenes de grabación de Jicofo, un navegador Chrome que se conecta como un usuario más a la sesión que grabará, y ffmpeg que se encarga de codificar el vídeo final.
Una característica a tener en cuenta de Jibri es que una sola instancia es capaz de grabar una sola sesión. Así que si quieres grabar más de una simultáneamente necesitarás tener más de un servidor/docker con Jibri.
Un servidor web y Jitsi Meet
Jitsi Meet, propiamente dicho, sería la parte frontal de todo el invento. Es una aplicación en Javascript que estará alojada en un servidor web. En el momento que escribo esto, nginx el servidor mejor soportado por Jitsi Meet para hacer este trabajo.
Otros componentes
Opcionalmente, en las últimas versiones, se puede instalar/configurar un servidor TURN/STUN para facilitar las comunicaciones de clientes detrás de NAT. De no hacerlo se pueden usar servidores públicos, en principio sin grandes compromisos (a mi entender) salvo la dependencia en la disponibilidad del servicio.
Jigasi es la última pieza del puzzle. Este componente permite integrar Jitsi Meet con una centralita de Voz IP. Ya sea para realizar llamadas desde una conferencia en curso (Meet ordena a Jigasi llamar) o para que participantes puedan unirse a una conferencia a través de una llamada telefónica (la centralita de Voz IP dirige las llamadas a Jigasi que las hace llegar a Jitsi Meet).
Realicé una instalación desde cero de Debian 10 Buster en una de mis máquinas y aún no había instalado el DNI (Documento nacional de Identidad) electrónico para hacer gestiones con las administraciones públicas españolas, así que me he puesto hoy a ello.
Ha sido relativamente sencillo.
1.- Paquetes necesarios para el lector y gestión de la entrada del PIN (tengo instalado KDE Plasma, y ya tenía pinentry-qt instalado)
sudo apt-get install pcscd pcsc-tools opensc
2.- Comprobar que el lector funciona: pinchar el lector USB con el DNI metido, y escribir
Aquí se instala el paquete pero luego da un error porque intenta abrir Firefox como root, cosa que el sistema no deja.
He mirado los contenidos del paquete y realmente lo que se hace es llamar a un script en Perl que es el que lanza Firefox, así que lo llamo como usuario normal:
$ /usr/share/libpkcs11-dnietif/launch.pl
Se abre Firefox y hay que seguir las instrucciones de la página web que aparece (file:///usr/share/libpkcs11-dnietif/launch.html) para cargar el módulo de seguridad de DNIe, y la autoridad de certificación FNMT (yo he cargado solamente el módulo de seguridad, porque creo que la FNMT ya la incorpora Firefox). Si veo que algo falla volveré aquí, terminaré las instrucciones, y actualizaré este artículo.
Una vez hecho esto, cierro Firefox, lo vuelvo a abrir, entro en una web que me pida el DNIelectrónico, y compruebo que funciona.
Realicé una instalación desde cero de Debian 9 Stretch en uno de mis portátiles y aún no había instalado el DNI (Documento nacional de Identidad) electrónico para hacer gestiones con las administraciones públicas españolas, así que me he puesto hoy a ello.
Ha sido relativamente sencillo.
1.- Paquetes necesarios para el lector y gestión de la entrada del PIN
Nota: hay varios paquetes pinentry disponibles para los distintos escritorios/gestores de ventana, yo como uso Plasma de KDE, pues uso los basados en Qt.
2.- Comprobar que el lector funciona: pinchar el lector USB con el DNI metido, y escribir
Se abre Firefox y hay que seguir las instrucciones de la página web que aparece, para cargar el módulo de seguridad de DNIe, y la autoridad de certificación FNMT.
Una vez hecho esto, cierro firefox. En el terminal indica que la instalación del paquete terminó con errores pero no tiene importancia. Vuelvo a conectar el lector del DNI con el DNI metido. Abro Firefox y compruebo que funciona.
Si tienes trato conmigo, me habrás oído hablar algo de Jabber/XMPP.
¿Te vienes a dar un paseo por la mensajería instantánea libre?
Jabber/XMPP
Es un protocolo de comunicación, como el correo electrónico o el FTP.
Antes se llamaba Jabber, ahora se llama XMPP
Permite la mensajería instantánea entre dispositivos usando internet (ordenadores, móviles, otros aparatos).
Permite charlar persona a persona y también en grupo.
El estándar es abierto y funciona con un servidor donde se crean las cuentas, y programas clientes (para ordenador o móvil) que sirven para enviar/recibir los mensajes. Te puedes comunicar con personas que tengan cuenta en un servidor XMPP distinto al tuyo (como en el caso del correo, tu servidor le pasará el mensaje al servidor del destinatario, que lo entregará).
Se puede usar con software libre (y gratuito) tanto en el lado del servidor como en los programas clientes, y permite el uso de cifrado punto a punto, para que ni los servidores ni los “mirones” vean el contenido de los mensajes.
Buena pinta ¿eh?
Registrarse
Mi cuenta es larjona@jabber.org
Me hice la cuenta hace algún tiempo y ese servidor está algo saturado, así que a la familia y amigos ahora les recomiendo otros, por ejemplo mijabber.es. Si quieres buscar otro diferente, tienes una lista con muchos servidores aquí: https://xmpp.net/directory.php
Para registrarse, puedes ir con un navegador web a la página del servidor y crear la cuenta, o puedes usar algún programa cliente que permita el registro automático (esto último no lo he probado).
Elige tu servidor, y elige un apodo que esté libre. Y ya está (bueno, algún servidor puede que te pida un correo electrónico para poder recuperar tu contraseña si se te olvida, o algún otro dato personal. Tú decides).
Programas clientes
Hay clientes para muchos sistemas operativos distintos.
También, muchos servidores, ofrecen un cliente web, para no tener que instalar nada. Por ejemplo: https://mijabber.es/jappix/
En GNU/Linux, Android, e iOS, usa el repositorio oficial para instalar el que quieras (puedes tener varios, si quieres). En Windows/OS X, visita las páginas web de los proyectos para descargar los ejecutables.
Yo uso Xabber en mi móvil (Android 2.x), y Conversations esporádicamente en mi tableta (Android 4.x). También he probado Tigase y Yaxim. Todos disponibles en F-Droid.
En el ordenador (con Debian), he probado varios: Psi, Psi+, Jitsi. Tengo pendiente probar Gajim.
En Windows sólo he probado Jitsi, pero conozco gente que usa Gajim o Pidgin.
Algunos clientes tienen estructura modular, y hay que instalar complementos para poder usar el cifrado, o la videollamada, u otras funciones avanzadas.
Chatear, y grupos
Una vez hemos instalado el cliente, iniciamos sesión con nuestra cuenta identificativa o JID, por ejemplo pepita.pulgarcita@mijabber.es y la contraseña.
Podemos añadir contactos (indicando sus JID), y se enviará una solicitud de autorización al contacto. También podemos entrar en grupos, (según el cliente que uses, verás que los llaman “grupos”, “salas”, “conferencias”, o MUC (“multi user chat”)). Por ejemplo en la sala redeslibres@salas.mijabber.es (haz clic y echarás un ojo ahora mismo desde el navegador) o crear tú uno en un servidor que permita la creación de grupos (salas.mijabber.es es uno de ellos, simplemente creas un nuevo nombre como “familiadepepitapulgarcita@salas.mijabber.es” y ya).
Cuando nos unimos a una sala de charla, podemos usar un apodo diferente, invitar a gente, proteger la sala con contraseña, y otras cosas.
En la conversación uno a uno, podemos activar el cifrado OTR, llamada de voz, o videollamada, si nuestro cliente y el de nuestro interlocutor lo soportan.
Envío de archivos
El estándar XMPP permite enviar/recibir archivos de dos maneras diferentes, y cada servidor y programa cliente decide de cuál manera lo hacen. Esto es un poco problemático, porque tú con tu cliente y tu cuenta en tu servidor podrás enviar archivos y quizá el servidor del receptor o el cliente no admite ese método… es cuestión de ponerse de acuerdo.
En general, los clientes de escritorio permiten el envío de archivos, y algunos clientes móviles (Conversations) también.
El método que funciona en todo caso es subir el archivo a algún sitio y proporcionar a tu interlocutor o interlocutores la URL Pero no te des por vencido/a, haz pruebas y actualiza frecuentemente tus clientes porque esta situación está evolucionando para bien.
Derivados
Existen aplicaciones que utilizan XMPP pero no son del todo compatibles, porque han adaptado el sistema a sus necesidades.
Kontalk
Un ejemplo de derivado libre es Kontalk (a partir de la versión 3, versiones anteriores no usaban XMPP).
El servidor es XMPP, pero el programa crea la cuenta de usuario aplicando una función “hash” al número de teléfono del usuario, con lo que se obtiene un JID algo complicado, tipo aedc28ed561209dfa98dee@beta.kontalk.net, y ése es el JID que tienes que decir a tus contactos que usan XMPP estándar para que te agreguen… Porque además el cliente de Kontalk no permite agregar contactos manualmente (aún), sólo usando la lista de números de teléfono. Además, no es posible hoy por hoy iniciar sesión con tu JID de Kontalk usando otro cliente XMPP, porque Kontalk usa cifrado GPG con un par de claves, en lugar de contraseña. Así que los usuarios de Kontalk, en la práctica, sólo pueden usar la aplicación de Kontalk para comunicar.
Kontalk, por ahora, no permite grupos, aunque se está trabajando en ello (así como en mejorar el sistema para que se puedan usar otros clientes XMPP para comunicarse).
El código del servidor y del cliente es libre, por lo que es posible, por un lado, instalar más servidores para crear una red federada como la XMPP estándar, y por otro, como sabemos, se puede adaptar y mejorar todo el sistema (de hecho, el desarrollo es comunitario, con 2 personas dirigiendo el proyecto y una comunidad bastante activa).
Whatsapp
Un ejemplo de derivado no libre es Whatsapp.
Han adaptado el servidor, cliente y protocolo para que se registren las cuentas automáticamente mediante el número de teléfono (de forma similar a como hemos explicado con Kontalk), y al no estar el código fuente disponible, es difícil saber cómo lo han hecho, y si han hecho más cosas. Han eliminado prácticamente cualquier posibilidad de control por parte del usuario: el usuario no puede saber su JID, tampoco puede especificar otro servidor para usar, y aunque se averiguara el JID, por acuerdo de términos de servicio, no puede usar otra aplicación distinta a la “oficial” para conectarse. Así, la empresa proveedora se ha reservado para sí todo el control. Todas las cuentas están en el mismo servidor, y usan el mismo cliente, y el usuario no puede cambiar nada; se asegura entonces el funcionamiento del envío de archivos (aunque éste se limita a sólo archivos de determinados tipos) y se asegura que todas las comunicaciones pasan por el servidor de Whatsapp, lo que permite controlar la comunicación, pero también perjudica a todos los usuarios si hay un problema en ese servidor.
En conclusión, la empresa usa XMPP para aprovechar sus ventajas en exclusiva, sin conceder al usuario esas ventajas que XMPP podría ofrecerle.
GTalk
GTalk era el cliente de mensajería instantánea de Google. Funcionaba usando el estándar XMPP, pero Google no implementó ciertos estándares de seguridad que exigen la mayoría de los servidores XMPP actuales. Como GTalk no era software libre, tampoco era posible arreglar esta situación por parte de la comunidad.
Cuando Google lanzó su nuevo sistema de mensajería y videollamadas, Hangouts (abandonando definitivamente GTalk), seguía sin ser libre, y además resultó incompatible con XMPP. Así, todas las personas que usaban XMPP estándar, dejaron de ver conectados a sus amigos que usaban GTalk/Hangouts, y viceversa. Google no informó a los usuarios de GTalk de que perderían la conectividad con sus contactos XMPP en otros servidores, al actualizar a Hangouts. Desde mi punto de vista, sólo eso es razón para dejar de usarlo y volver al XMPP estándar creando una cuenta en cualquier (otro) servidor…
Los usuarios de Hangouts tienen además el problema de la centralización del servidor, como hemos comentado anteriormente con Whatsapp. Si su servidor tiene problemas, no podrán usar ese sistema (no hay otro servidor de Hangouts donde crearse cuenta).
Conclusiones
Cuando nos dicen que determinada empresa/aplicación de mensajería ofrece mejor experiencia de usuario, es interesante pensar cómo lo consigue, o a costa de qué. Desde mi punto de vista, centralizar la comunicación haciendo que todos pasemos por un mismo servidor es hacer “trampa” (y además, tiene implicaciones muy importantes acerca de la privacidad de las comunicaciones, por ejemplo).
Llevo un tiempo usando XMPP, y veo que las aplicaciones de cliente y servidor están en continua evolución, resolviendo retos nada triviales (envío de archivos, videollamada, compatibilidad móvil/PC, comunicación síncrona y asíncrona…), sin renunciar a la interoperatividad y la federación (elementos claves de la supervivencia de una red que quiera ser una verdadera red) y a poner el control en manos de los usuarios y sus comunidades (elementos claves para que podamos comunicarnos con libertad).
Si piensas que el ecosistema XMPP se mueve despacio, y necesitaría un buen empujón para alcanzar la usabilidad y el nº de usuarios de los otros, ¿a qué esperas para colaborar? Úsalo, estúdialo, mejóralo, difúndelo. Es software libre, ¡tienes todo el derecho a ello!
Me pregunta un viejo amigo que está trabajando como coordinador de un programa de Ingeniería en una Universidad del suroccidente, con el fin estructurar mejor el contenido del programa y graduar mejores ingenieros:
¿Cuál consideras que serían las competencias que debería tener todo ingeniero en electrónica y telecomunicaciones para que pueda afrontar el mercado laboral?
Quiero compartir mi respuesta, que fue la siguiente:
Hola,
Muchas gracias por tenerme en cuenta para esto, para mí el cierre de la
brecha entre empresa y academia siempre ha sido una preocupación desde
que estaba en la universidad.
Hay varias cosas que en mi experiencia los ingenieros de hoy en día deben aprender y que las agrupo en 3 categorías:
1. Habilidades técnicas:
Lo de siempre, los ingenieros deben saber cómo resolver un problema,
analizándo todos los requisitos a cumplir de manera sistémica. Hoy en
día es más importante saber cómo buscar la información necesaria para
resolver los problemas que aprenderla de memoria,
ser capaces de llegar al fondo de cómo funcionan las cosas, un ingeniero
debe tener tanto una visión global de todas las tecnologías, como un
conocimiento profundo de alguna de ellas en particular. Y sobretodo,
leer la Carta a García.
Una habilidad que es importante inculcar, es la de publicar, compartir,
crear un portafolio de proyectos que son la carta de presentación,
participar en comunidades, tener un repositorio de código, contribuir a
un proyecto open source, publicar en blogs, etc.
Ojalá todo en INGLES
Pero lo más importante sería enseñarles todas las variables que hacen
que un producto sea de gran calidad: desde el diseño, pasando por la
creación, pero no quedarse ahi, sino pensar también cómo eso se inserta
en un entorno de producción escalable, cómo se
debe probar, documentar y mantener en la vida real.
2. Habilidades de negocios
En un mundo globalizado no solo se requiere generar soluciones, sino
saber cómo éstas se llevan al mercado. Los ingenieros de hoy deben
entender cómo se gestiona un proyecto con herramientas como el PMBOK,
pero también con AGILE, Scrum, etc. Hay que enseñarles
a que sepan plantear un proyecto como un caso de negocio, que piensen
como emprendedores, que no se queden solo en una idea, sino que sepan
cómo llevar esa idea a satisfacer un mercado (Lean Startup), cómo
vender, cómo manejar un presupuesto.
3. Habilidades humanas
Finalmente, los ingenieros tienden a ser muy cuadrículados y encerrados
en su mundo. Hay que cultivar habilidades de comunicación, oral y
escrita, habilidades gráficas, cómo hacer una presentación agradable a
la vista, que comunique las ideas, cómo diseñar
interfaces de usuario agradables, usables, deseables. Cómo interactuar
con un equipo multidisciplinario, cómo mantener un ritmo de vida
productivo y saludable.
Lo más importante es que sepan cuál es su pasión. Un ejercicio interesante que
se me ocurre, sería ponerlos a investigar ofertas laborales en bolsas de
empleo, o perfiles de gente muy dura en LinkedIN, que ellos vean un
perfil o Biografía de alguien que sea su modelo
a seguir. Y luego que afronten su aprendizaje con ese perfil en mente.
Que cuando salgan, estén ya perfilados hacia una meta de carrera real.
Son muchos los retos de un ingeniero en la vida real, espero que esta información te sea de utilidad,
Página web de la campaña de financiación de MediaGoblin. ¡Con un vídeo genial!
MediaGoblin es un sistema de publicación en la web que puede alojar contenidos de todo tipo (como un YouTube + Flickr + SoundCloud + otros). Es software libre, así que está disponible para personas, comunidades, organizaciones y empresas que quieran utilizarlo, desplegarlo en su propia infraestructura, o adaptarlo.
Mediagoblin es uno de los proyectos en los que participo, traduciendo la interfaz al español, y junto con Debian, ocupa una parte especial de mi corazón (y mi tiempo libre). Me gusta el estilo de su comunidad, muy inclusiva, y Chris Webber, el desarrollador principal del proyecto, anima mucho esa inclusividad y buen rollo que se respira. Sólo estando un rato en el canal IRC de FreeNode (#mediagoblin) uno se da cuenta de la capacidad resolutiva de muchos de sus miembros, a la par que siempre intentan trabajar a gusto para ser feliz y viceversa.
El software en sí es muy prometedor. Sólo el hecho de tener una interfaz limpia, traducida a varios idiomas, y la capacidad para alojar y visualizar muchos tipos de archivo usando siempre estándares abiertos y hace que me guste.
El que me conoce, sabe que amo la simplicidad de por ejemplo el archivo multimedia de Debian o el de la conferencia FOSDEM: un árbol de carpetas y archivos. Navegas hasta donde está lo que te interesa, te lo descargas, y ya está, lo ves en tu equipo. Pero cuando vi el archivo multimedia de LibrePlanet 2013 (que usa MediaGoblin), con miniaturas de todas las charlas allí mismo, la interfaz en español (por la detección de idioma de mi navegador), la etiqueta de licencia en cada charla, poderla descargar en varios formatos o verla dentro del navegador, entendí que mucha gente prefiere algo así, visualmente más atractivo, y eso no tiene por qué suponer una gran carga adicional en el lado del que despliega la infraestructura (MediaGoblin es más ligero respecto a recursos y administración que un gestor de contenidos estándar, por ejemplo, y está pensado para escalar bien tanto hacia arriba como hacia abajo).
Archivo multimedia de la conferencia LibrePlanet
Sé que tanto Debian como FOSDEM funcionan con el trabajo voluntario de personas (a veces poquitas) en su tiempo libre, y con un presupuesto muy ajustado, soy feliz con sus elecciones respecto a repositorios de vídeo. Pero si algún día deciden animarse o encuentran los recursos necesarios para desplegar y mantener un MediaGoblin, ¡serán aún más geniales!
Mis cosas están en una cuenta gobblin.se, de Joar Wandborg, otro desarrollador de MediaGoblin, que amablemente ofrece cuentas gratuitas en el servidor que mantiene. Ahí sólo tengo cositas públicas. En mi familia hemos comentado varias veces el tema de alojar y compartir fotos y vídeos nuestros: yo vivo en una ciudad distinta, y por ahora, cada uno mantiene su archivo multimedia en su ordenador, enviando por correo, de vez en cuando, una selección de las fotos y vídeos más interesantes, o pasándonoslo en un pincho USB cuando nos vemos. De cuando en cuando hablamos por videoconferencia, pero por ejemplo, yo no las grabo, porque serían archivos grandes difíciles de compartir por correo.
Así que a menudo me planteo la posibilidad de montarme un servidor MediaGoblin con control de acceso, para que todos podamos subir y ver la historia digital de la familia, y espero hacerlo a lo largo del año, cuando compre un equipo fijo que pueda tener encendido permanentemente.
Entretanto, acabo de donar por segunda vez (lo hice también en la primera campaña en 2012). Me parece muy importante que los proyectos comunitarios también salgan adelante y mantengan su independencia, con una planificación guiada por las prioridades de la propia comunidad. La financiación colectiva puede hacer esto posible, y MediaGoblin ya ha demostrado que sabe materializar las expectativas de los que le apoyan, y con creces (y si no, echa un vistazo al vídeo, donde muestran todo lo hecho el pasado año. Puedes poner subtítulos en español pulsando en el iconito “CC” que hay junto al volumen). ¿Te animas a unirte a la Fuerza Goblin? No te arrepentirás.
(Si tienes dificultad para donar porque la página de la campaña y la de la donación están en inglés, puedes echar un vistazo a este artículo de GNU/Linux Vagos donde explican (en español) casi todo lo que pone en la página de la campaña, y también, contactar conmigo, y te aclararé todas las dudas que pueda).
He estado usando Pump.io desde marzo de 2013 para pruebas, y más intensamente desde la migración de Identi.ca en julio de 2013.
He escrito varios artículos sobre Identi.ca, mi red social favorita, y también sobre la migración.
Después de varios meses y desarrollo activo no sólo en el software núcleo, sino en muchos servicios de terceros, y después de muchas discusiones, informes de error, conocimiento compartido y ‘vida en el pumpiverso’, ¿cómo veo la red pump.io ahora?
Nota: esto es sólo mi opinión como, digamos, usuaria implicada de pump.io. Digo “implicada” porque lo uso mucho, he probado varios clientes, he abierto varios informes de error y ayudado a resolver otros, hago clasificación de fallos en el sistema de seguimiento de errores e intento ayudar a los usuarios principiantes. Pero no soy parte del equipo de desarrollo de pump.io y no estoy más en contacto con el líder del proyecto, Evan Prodromou, que lo que pueda estar cualquier otro usuario o fan. Así que advertencia: esta es mi humilde opinión particular, y no refleja la visión oficial del proyecto pump.io.
Usable
La red Pump
El software es usable. Está instalado no sólo en los servidores de E14N, otras personas lo han desplegado en sus máquinas y lo están usando. Algunas personas lo han instalado en una Raspberri Pi, otras en un servidor privado virtual (VPS), otras en su PC personal. Algunas personas alojan sólo a un usuario (ellos mismos), otras tienen más usuarios (registro abierto, o bajo invitación).
E14N, la empresa que ofrece el software pump.io, ofrece identi.ca para los usuarios que ya tenía, y algunas instancias públicas donde puedes registrar una cuenta de manera gratuita: fmrl.me , pumprock.net , urmf.net , pumpbuddy.us , hotpump.net , pumpdog.me , pumpit.info , 1realtime.net , microca.st , pumpity.net.
El servidor e14n.com también es un servidor pump.io, pero no permite registro de cuentas.
El número de instancias/usuarios conocidos por OFirehose (la manguera, un nodo donde puedes registrar tu servidor pump.io, para ofrecer una línea temporal pública que abarque toda la red) es en pumplive.com. Probablemente hay más instancias en redes privadas o no registrados allí.
Jeremy Pope mantiene el sitio pumpstatus.jpope.org donde puedes ver el tiempo de actividad sin cortes (uptime) y comprobaciones para muchos servidores.
Por lo que he visto en este tiempo, los cortes o caídas, cuando los hay, se deben en la mayor parte de los casos a fallos de hardware, problemas relacionados con la configuración o administración del sistema. En muchos casos, el tiempo de actividad sin cortes (uptime) es corto debido a reinicios del servidor para actualizar el código, y así obtener alguna característica nueva o arreglar problemas. El que no haya informes de error relacionados con rendimiento o errores de operación abiertos durante largo tiempo muestra que se arreglan rápido, por lo que puedo contar.
Desde la perspectiva de administración de sistemas: desplegar/mantener un servidor pump.io
Sobre la instalación, no puedo decir que sea difícil o fácil. Considero que soy una usuaria avanzada, aprendiz de administradora de sistemas (conocimientos suficientes para instalar una distro GNU/Linux, o una pila LAMP, o descargar y compilar código fuente si ese software no está empaquetado para mi distribución y las dependencias están listadas en algún sitio).
He intentado instalar pump.io en mi portátil (solo por saber si soy capaz de hacerlo, y probar algunos cambios en el código, no para uso diario). En ese momento, node.js no estaba empaquetado para Debian, pero conseguí descargarlo, compilarlo, instalarlo, y repetir el proceso para el servidor pump.io. Sin embargo, no instalé/configuré una base de datos etc, porque como digo sólo quería probar la interfaz de usuario. Ahora que node.js está empaquetado para Debian, supongo que la instalación es más fácil.
Hay documentación sobre la instalación de pump.io en varias plataformas en la wiki.
El “ecosistema” Pump
Además de pump.io, E14N desarrolla algunas otras piezas de software para determinadas características o tareas en la red Pump. Entre ellas, tenemos:
OpenFarmGame (el juego de la granja abierta) es un juego de red social para mostrar las posibilidades de la red Pump
Spamicity.info es un servidor que filtra spam (mensajes comerciales no solicitados) en la red Pump
OFireHose (la manguera) proporciona una línea temporal pública de la red Pump en formato ActivityStreams (JSON)
pump2rss proporciona una línea temporal pública de un determinado usuario en formato RSS
pump2status.net (en desarrollo) permitirá conectar una cuenta de pump.io con una de StatusNet, actuando como un puente
ragtag.io (en desarrollo) permitirá ver todos los objetos públicos de la red Pump que están etiquetados con un determinado ‘hashtag’ (#).
Otras personas han desarrollado librerías, clientes y herramientas para usarlos en la red pump. La mayoría de ellos están enlazados en la pump.io wiki. Los que subrayo yo:
PyPump es una librería Python para interactuar con un servidor pump.io
Bashscriptville es un conjunto de guiones o scripts bash que permiten publicaro iformación de determinadas fuentes en la red pump, como “The Word of the Day” (la palabra del día, en inglés), los cómics XKCD, insultos Shakespeareanos, la imagen astronómica del día, y otros.
El bot conversacional XR115 se ha unido a pump.io y ahí está aprendiendo.
Necesita usuarios
Principalmente por el efecto red. El éxito de una red social es altamente dependiente del número de personas usándola (también depende de que sea flexible, poderosa, brillante y todo eso, pero podríamos discutir qué va primero).
Otra razón es que ahora, la mayoría de los usuarios de pump.io tienen una visión del lado de StatusNet. Me gusta StatusNet, es un gran software, pero quizá estamos atascados intentando hacer que pump.io sea como StatusNet y nueva gente pueda traer nuevas, mejores ideas.
Pero de dónde pueden venir usuarios a pump.io? Veo tres tipos de usuarios:
Gente que no usa ninguna red social: si eres nueva en las redes sociales, por favor, usa una basada en software libre. Puede ser Pump.io, Friendica, Diaspora*… la que sea. Yo conozco Pump.io, y por eso la recomiendo. Llegué a pump.io por accidente, ya que usaba Identi.ca para microblogueo, y sabiendo que iba a haber una migración de StatusNet a pump.io, empecé a curiosear en la plataforma. Es nueva, así que muchas cosas aún están en desarrollo, pero es nueva, flexible y moderna, ha aprendido de los fallos de otras plataformas. ¿Por qué no? Y lo más importante: ¡hay gente guay en pump.io! No hay una actividad abrumadora, sin publi, sin spam (pero si lo quieres, puedes ir a la manguera
Gente que usa otras redes sociales: Pump.io puede ser una más, o un sustituto de Facebook, o Google+, por ejemplo. Si eres una empresa o todos tus amigos están en otras redes sociales, y “no puedes no estar allí”, quizá quieras esperar hasta que tengamos puentes para publicar simultáneamente en todos los sitios (en cualquier caso, mira los que ya tenemos, quizá son suficientes para tus necesidades, o puedes usar Friendica para publicar simultáneamente en todos los sitios con un esfuerzo mínimo). Si tienes un cierto interés en el mundo del software libre (quizá contribuyes a un proyecto, o eres una empresa basada en software libre, o simplemente te gusta cacharrear), estaría bien que tuvieras presencia en una red social de software libre como ésta.
Gente buscando redes sociales para uso privado: en mi opinión, pump.io parece perfecta para montar una red privada familiar o una red social institucional dentro de una intranet. Recuerda, está pensada para ser escalable hacia arriba y hacia abajo, y federada desde el principio. Puedes configurar una interfaz web común pero también dar libertad a los usuarios para usar el cliente que les guste. Estamos trabajando en la internacionalización y localización, pero si no puedes esperar, simplemente traduce las cadenas que hay en el código y las plantillas utml y a correr. Es software libre, ¡puedes hacerlo! E14N está trabajando para proporcionar cajas con pump.io listas para enchufar. Posee tus datos, disfruta tu comunicación.
Necesita amor
Sólo soy una usuaria de pump.io, curioseo en el canal IRC, en el gestor de informes de fallos (bueno, hago algo de clasificación y 1ª línea), y sigo a Evan y a los hackers de pump.io. Para nada soy voz oficial de las necesidades o planificación de pump.io, pero aquí están mis ideas personales sobre cómo pump.io podría mejorarse y cómo podemos ayudar.
Planificación
Estoy segura de que Evan tiene una planificación clara para nuevas características de pump.io y corrección de fallos. Podemos oler parte de ella en el gestor de informes de fallos, ya que algunos casos están etiquetados con un hito de versión, y otros han sido cerrados con el mensaje de que terceras partes deberían encargarse de mejorar esos aspectos. Pero una planificación clara podría ayudar a los usuarios a saber qué esperar, y a los contribuidores a ayudar de manera más efectiva.
Quizá es simplemente cuestión de clasificar los casos abiertos por hito temporal, y escribir una página wiki. Mmm preguntaré a Evan sobre ello.
En el lado del usuario, creo que es útil revisar la wiki de cuando en cuando para ver las características más importantes que ya están implementadas (en pump.io en sí o por terceras partes), y buscar en el gestor de informes de fallos antes de enviar un problema supuestamente nuevo. O quizá preguntar en el canal IRC.
Página de ‘estado’ de E14N, página de contacto, y ayudantes sysadmin
No voy a decir cómo Evan tiene que dirigir sus máquinas o su negocio. Así que por favor toma este párrafo sólo como una humilde opinión que se puede tirar a la papelera si no es útil.
Los servidores de E14N (especialmente identi.ca, pero no sólo) son la imagen pública del software pump.io y su red. Y muchas personas puede que no sepan distinguir entre un problema en el software y un problema puntual en la red o el sistema. Muchas personas no saben dónde informar de problemas o solicitudes que no están ligadas al desarrollo de software, o saben que es por correo electrónico a admin [at] e14n.com pero no saben si ya alguien informó del problema.
Por ahora, pumpstatus.jpope.org está siendo de gran ayuda y algunas personas comentan en el canal IRC cuando tienen problemas, antes de enviar un correo. Pero tener una página web de “estado” donde mirar si estamos experimentando problemas podría ayudar. Y quizá dar permisos de escritura en esa página a algunas personas en el rol de “ayudantes sysadmin” ayudaría también.
Funcionalidad que da el control al usuario
Pump.io es software libre, esto significa que el usuario puede controlar lo que el programa hace. Pero no todo el mundo sabe cómo cacharrear en node.js para modificar el programa y que haga lo que ellos quieren, y no están en condiciones de instalar su propia instancia. Algunas funcionalidades que, en mi opinión, atraerían usuarios y mantendrían a los usuarios existentes felices e implicados serían:
Activar la recuperación por correo electrónico y notificaciones en el resto de los servidores de E14N que no son identi.ca
Posibilidad de hacer copia de seguridad de una cuenta, borrarla, cambiar la dirección de correo electrónico, configurar las notificaciones por correo electrónico.
Buscar publicaciones y usuarios.
Internacionalización / localización de la interfaz web a distintos idiomas.
Mostrar contextos en la interfaz web.
Una línea temporal pública (como la manguera), accesible con un navegador web, sin spam (o quizá una vista de “temas candentes”, con las publicaciones públicas que se comparten o se marcan como “me gusta” en cada momento). Una ventana donde el posible nuevo usuario pueda mirar.
¡Contribuidores!
Enrico Zini dijo una vez: “No te preguntes qué puedes hacer por Debian. Pregúntate qué puede hacer Debian por tí. Y machácalo hasta que lo haga”. Creo que este pensamiento va bien también con Pump.io. Hay muchas piezas del código que ya están escritas y que puedes copiar y toquetear, y hay otros muchos proyectos (no sólo el núcleo, recuerda los clientes, las librerías, proyectos hermanos…) donde tu ayuda es de gran valor.
Hey, y no digas que “no sé JavaScript ni node.js”. Yo tampoco… pero el código es código, puedes abstraer la sintaxis y aprender y entender (o más o menos) cómo funciona. Otras piezas del ecosistema pump.io están escritas en otros lenguajes. O puedes ayudar en el gestor de informes de fallo intentando reproducir errores o encontrar duplicados, o leer/escribir documentación o preguntas frecuentes, sugerir ideas, probar características/clientes/plataformas…
Y si eres programador(a), por favor échale un vistazo al gestor de informes de fallos y las solicitudes “pull” de cuando en cuando. Probablemente habrá algunas propuestas para arreglar fallos que puedes mejorar o apoyar para que se incorporen más rápido, o rechazarlas para que el remitente pueda repensar su propuesta o simplemente ir a ayudar a otra parte del código o del sistema.
Promoción
Finalmente, creo que estaría bien tener una presentación en vídeo sobre pump.io (digamos 5 minutos, quizá menos) que pueda ser traducida a diferentes idiomas y compartida en todos los sitios para correr la voz sobre esta red social. Quizá ya está hecha (si sí, ¡por favor enviadme un enlace!). Quizá algunos usuarios pueden intentar hacerla. Pero creo que yo no soy la persona adecuada para esta tarea. Mira este artículo, ¡es demasiado largo! Escribir algo para sólo 5 minutos es una tortura para mí
El propósito de este artículo es realizar un análisis de las principales
variables del entorno y capacidades del emprendedor que se deben tener
en cuenta antes de decidir si es un buen momento para iniciar un
emprendimiento. Se realiza una comparación de estos factores entre dos
casos de emprendimiento Latinoamericanos de características diferentes:
la empresa Laboratorios Skudmart, de Colombia, y la empresa Kauel, de
Chile.
An exercise on exploring and deconstructing a well-known brand to derive the vision, personality and language, to then identify a new concept (product or experience) that that brand could take to market.
La Bañera. Óleo sobre lienzo (50x70cm). Va a estar 20 dias expuesta en la biblioteca de la universidad CEIPA, en Sabaneta, como parte de las obras del semestre del taller de extensión de la escuela Débora Arango.
Hace unos dias Guillermo Burastero me llamó para comentarme que le habían pedido una nota en el diario local de Bahía Blanca, La Nueva Provincia, para que habláramos de software libre. La entrevista se concretó y he aquí el resultado (y acá en PDF).
Hice algunas menciones a Debian, pero bueno, no todo es posible a veces :-)
Tip: los nombres no coinciden con las fotografías. Les dejo adivinar el orden correcto ;-)
El sábado 20 de Abril se va a llevar a cabo el Hardware Freedom Day en todo el mundo, y Argentina no es excepción. Este año tenemos la suerte que se realice en dos lugares: La Plata (que cuenta con Alejo como uno de los coordinadores) y Buenos Aires.
A mi me van a quedar un poco lejos, pero invito al que pueda a acercarse al evento.
En mi trabajo ha surgido la necesidad de crear una infraestructura de LDAP+kerberos, que voy a montar sobre (adivinaron) Debian. Si bien en la web hay varios artículos al respecto, ésto es lo que les recomiendo dentro de lo que vengo leyendo:
Un Red Book de IBM muy bueno al respecto, ideal para arrancar si se desconoce totalmente el tema. Si van a usar OpenLDAP, con leer los tres primeros capítulos alcanza.
Un libro en la web de Zytrax, mas informal pero con muchos ejemplos, excelente para leer a continuación del anterior.
Un problema general que me he encontrado en convertir los ejemplos de configuraciones de slpad.conf al formato manejado dentro del mismo árbol de LDAP. Pero si hubiese leído las cosas en el orden que puse arriba, me hubiese sido mas fácil de entrada :-)
Un amigo me recomendó mirar la wiki de DebianLan para lograr un setup mucho más rápido. Todavía no he llegado a ésa parte.
Mientras reviso los bugs del equipo Qt-KDE de Debian, no es raro encontrar gente que reporta que se sesión de KDE está muy lenta. La gran mayoría de las veces el problema es que la interfaz de loopback (aka lo) no está habilitada. A veces el usuario hizo algo mal, a veces algún manejador de redes metió la pata, pero el resultado final es el mismo: KDE está lento.
Un usuario llenó un bug en KDE upstream pidiendo por un diálogo que avise al usuario en caso de que ésto ocurra. esperemos que sea implementado :-)
Bueno, pero... ¿como chequeo de que la interfaz esté activa?
Y bueno, hace unos quince meses ya (en mayo del año pasado) tuve el placer de recorrer Centroamérica en bus acompañado de un bello grupo, fue un proyecto muy bonito del que pude ser parte. Libre Bus, un bus que recorrió desde Costa Rica hasta Guatemala durante quince días.
Este año el proyecto vuelve de nuevo, pero esta vez será en el cono sur, lamentablemente no seré parte de la travesía, pero estoy seguro de que será una experiencia parecida o mejor. Durante el viaje se hablará sobre Cultura Libre, Software Libre, Libertad de Expresión, Libertad para compartir y Educación Abierta, manejando dos ejes transversales: Biodiversidad y medio ambiente y Género.
Esto arrancará el 28 de agosto en la ciudad de Valdivia en Chile y tiene programado terminar en La Plata, Argentina, serán 30 días increíbles y 8,000 kilómetros en un bus recorriendo Chile, Argentina, Uruguay y Paraguay, donde se compartirá mucho conocimiento y experiencia, así que si estás en alguno de los cuatros países que mencioné antes, revisá la agenda para que podás llegar y participar en los eventos (de paso me saludan a Teresa, Renata y Jaime con quienes estuve el año pasado
Una vez que inicie, vas a poder ir viendo fotos en flickr que el grupo de librenautas irá subiendo.
Ya había tardado en escribir sobre esto, con tantas cosas por hacer, el blog no ha logrado convertirse en una prioridad y por eso olvido escribir
A veces cuesta pensar que en un país como Nicaragua podría existir censura a través de la Internet, siempre vemos esto como algo muy Oriente Medio y se nos olvida que también puede pasar acá, en la región centroamericana, y ya lo vivimos con el pueblo hondureño y el golpe de Estado al presidente Zelaya, la represión a través de la Internet fue vivida por muchas personas.
El 29 de noviembre pasado, un colectivo llamado “Claro que NO” decide publicar un blog como un medio donde los clientes insatisfechos con el servicio de Claro Nicaragua (empresa del grupo América Móvil, del millonario mexicano Carlitos Slim) puedan expresarse. Parece que a algunos trabajadores de CLARO Nicaragua esto no les gustó y procedieron a realizar la (para muchas personas) acción más descarada, irrespestuosa y atropelladora en contra de nosotros, los clientes de ellos, quienes mes a mes les pagamos.
A los pocos días de haber nacido este blog, la empresa en mención mandó a bloquear la dirección IP del servidor donde se aloja el blog y con esto lograron que las personas quienes tienen una conexión de Internet con CLARO no puedan visitar el sitio web.
No ha sido una vez la que yo personalmente me he quejado en twitter sobre este bloqueo y la única respuesta que he recibido por parte de ellos es “NO HEMOS BLOQUEADO NADA”.
El día 23 de diciembre el periodista Oliver Gómez se reune con Federico Michell, miembro del colectivo claro que no para reallizarle una entrevista, este mismo día, también se realiza una entrevista con la empresa CLARO Nicaragua y hasta esta fecha, los directivos de la empresa siguen sin reconocer el bloqueo hasta que un técnico hace una prueba en vivo al periodista y ya con la prueba frente a ellos, no tienen de otra que decir que si es cierto y por supuesto, aceptaron mel bloqueo hasta que se comunicaron con el Gerente General de Claro Nicaragua. Tristemente, todavía reconocen que hicieron el bloqueo ya que hay difamación en contra de ellos y calumnias.
Desde cuando un proveedor de Internet tiene potestad para cerrar descaradamente un sitio web? La Internet no supone ser libre? CLARO Nicaragua puede bloquear un sitio web donde sus clientes manifiestan sus descontentos? Los clientes de una empresa tienen todo el derecho de quejarse por un mal servicio prestado y la empresa proveedora de Internet no tienen ningún derecho de, a criterio propio, bloquear sitios web.
Pero cosas como estás no se leen en los medios de comunicación escrita como La Prensa, El Nuevo Diario, Confidencial, La Brújula, pues no se han atrevido a escribir un reportaje sobre esto. Sí, Confidencial y La Brújula publicaron algo, pero lo hicieron en secciones de reporte ciudadano y “libre expresión”, donde se quitan un peso de encima con la empresa CLARO al ser secciones del periódico escrita por sus lectores, pues no se atreven a hacer un reportaje periodístico de verdad. Igual los canales de televisión o radios, nadie se ha atrevido a hablar al respecto, por temor a perder el dineral que les da CLARO por publicidad.
Todos los medios de comunicación son expertos en poner en primera plana reportajes en contra del gobierno, pero ninguno se atreve a hablar de la censura impuesta por una mega empresa como CLARO, es triste ver como medios de comunicación que están “al servicio y la verdad de la justicia” se hacen los sordos cuando se les pregunta si piensan defender a la población y denunciar una censura. Igual los grupos juveniles que defienden la libertad de expresión que tenemos como ciudadanos, solo saben defender la libertad si es algo del gobierno, pero cuando es una empresa privada, lo olvidan.
Fue hasta el día miércoles 28 de diciembre, que el periodista Oliver Gómez publica un artículo sobre este caso en El Nuevo Diario, una labor increible e inesperada, no nos imaginabamos que esto iba a llegar a pasar. En dicho artículo, Azalia Salmerón, Gerente de Comunicación Corporativa de Claro, explicó que el bloqueo lo realizaron aduciendo que no toleran el libertinaje, WTF? somos sus clientes y si nos quejamos no es por difamar, es que no nos brindan un buen servicio. No es posible que nuestro proveedor tilde de difamaciones y calumnias las quejas nuestras.
Que dicen ustedes? felicitamos a Claro Nicaragua por darnos el «lujo» de expresarnos?
Los videos de la dudesconf, (la mini-debconf
española) están ya disponibles en
http://dudesconf.org/2010/programa.html. Una vez más, me gustaría
aprovechar estas líneas para darles las gracias a todo el mundo que
trabajo para hacer la tercera edición de dudesconf posible.
Poco a poco, empieza a haber mucho material en español sobre Debian,
como echaba en falta tener un sitio desde donde enlazarlo todo, he
creado una página en el wiki de debian:
http://wiki.debian.org/VideoTalks/Spanish. Si sabes de algún video, no
dudes en añadirlo :)
Actualización: Hay problemas con los enlaces de los videos de las
dudesconf, espero que en unos días estará arreglado.
(English: if you want to know what this post is about, read
this.)
Ante la inclusión en el Anteproyecto de Ley de Economía sostenible de
modificaciones legislativas que afectan al libre ejercicio de las
libertades de expresión, información y el derecho de acceso a la cultura
a través de Internet, los periodistas, bloggers, usuarios, profesionales
y creadores de internet manifestamos nuestra firme oposición al
proyecto, y declaramos que:
Los derechos de autor no pueden situarse por encima de los
derechos fundamentales de los ciudadanos, como el derecho a la
privacidad, a la seguridad, a la presunción de inocencia, a la
tutela judicial efectiva y a la libertad de expresión.
La suspensión de derechos fundamentales es y debe seguir siendo
competencia exclusiva del poder judicial. Ni un cierre
sin sentencia. Este anteproyecto, en contra de lo establecido en
el artículo 20.5 de la
Constitución,
pone en manos de un órgano no judicial -un organismo dependiente del
ministerio de Cultura-, la potestad de impedir a los ciudadanos
españoles el acceso a cualquier página web.
La nueva legislación creará inseguridad jurídica en todo el sector
tecnológico español, perjudicando uno de los pocos campos de
desarrollo y futuro de nuestra economía, entorpeciendo la creación
de empresas, introduciendo trabas a la libre competencia y
ralentizando su proyección internacional.
La nueva legislación propuesta amenaza a los nuevos creadores y
entorpece la creación cultural. Con Internet y los sucesivos
avances tecnológicos se ha democratizado extraordinariamente la
creación y emisión de contenidos de todo tipo, que ya no provienen
prevalentemente de las industrias culturales tradicionales, sino de
multitud de fuentes diferentes.
Los autores, como todos los trabajadores, tienen derecho a vivir
de su trabajo con nuevas ideas creativas, modelos de negocio y
actividades asociadas a sus creaciones. Intentar sostener con
cambios legislativos a una industria obsoleta que no sabe adaptarse
a este nuevo entorno no es ni justo ni realista. Si su modelo de
negocio se basaba en el control de las copias de las obras y en
Internet no es posible sin vulnerar derechos fundamentales, deberían
buscar otro modelo.
Consideramos que las industrias culturales necesitan para
sobrevivir alternativas modernas, eficaces, creíbles y asequibles
y que se adecuen a los nuevos usos sociales, en lugar de
limitaciones tan desproporcionadas como ineficaces para el fin que
dicen perseguir.
Internet debe funcionar de forma libre y sin interferencias
políticas auspiciadas por sectores que pretenden perpetuar
obsoletos modelos de negocio e imposibilitar que el saber humano
siga siendo libre.
Exigimos que el Gobierno garantice por ley la neutralidad de la
Red, en España
ante cualquier presión que pueda producirse, como marco para el
desarrollo de una economía sostenible y realista de cara al futuro.
Proponemos una verdadera reforma del derecho de propiedad
intelectual orientada a su fin: devolver a la sociedad el
conocimiento, promover el dominio público y limitar los abusos de
las entidades gestoras.
En democracia las leyes y sus modificaciones deben aprobarse tras
el oportuno debate público y habiendo consultado previamente a todas
las partes implicadas. No es de recibo que se realicen cambios
legislativos que afectan a derechos fundamentales en una ley no
orgánica y que versa sobre otra materia.
Este manifiesto, elaborado de forma conjunta por varios autores, es de
todos y de ninguno. Se ha publicado en multitud de sitios web. Si estás
de acuerdo y quieres sumarte a él, difúndelo por Internet.
Hemos trabajado mucho para que la actualización funcione sin problemas,
pero dado que el cambio es tan grande, algunos problemillas apareceran
aquí y allí. Uno de los mayores problemas ha sido que estabamos usando
.kde4 para guardar los datos de configuración de KDE 4 y ahora ha
llegado el momento de volver .kde.
Como había varias opciones de migración, para que los usuarios pudieran
escoger la que preferian, dentro del equipo de Debian KDE se ha creado
una herramienta de migración llamada
Kaboom.
Hay que tener en cuenta que habrá algunas incosistencias en unstable los
días siguientes a subir KDE 4.2.2, así que por favor, sed pacientes.
Aun estamos probandolo todo y no vamos a subir nada hasta que no
pensamos que todo va bien, así que podríamos tardar 2 semanas en lugar
de varios días. De nuevo, paciencia :)
Si quieres seguir usando KDE 3.5.10 algunas semanas más, simplemente no
actualices aun. Pero si quieres seguir usando KDE 3.5.10 durante meses,
quizás deberias pensar en usar Lenny.
Ahora una nota personal. KDE 4.2 es un gran cambio sobre KDE 3.5 y es
normal que al principio no te guste mucho. Pero pienso que la mayoría de
los usuarios de KDE 3 se sentirán a gusto en KDE 4 tras varios días de
uso. Solo hay que descubrir la nueva filosofía del sistema y encontrar
nuevas formas de hacer las cosas. Una vez que KDE 4.2 esté en unstable,
se podrán subir al archivo un montón de aplicaciones de terceros, sobre
todo plasma widgets o plasmoids, que harán que KDE 4 sea incluso mejor.


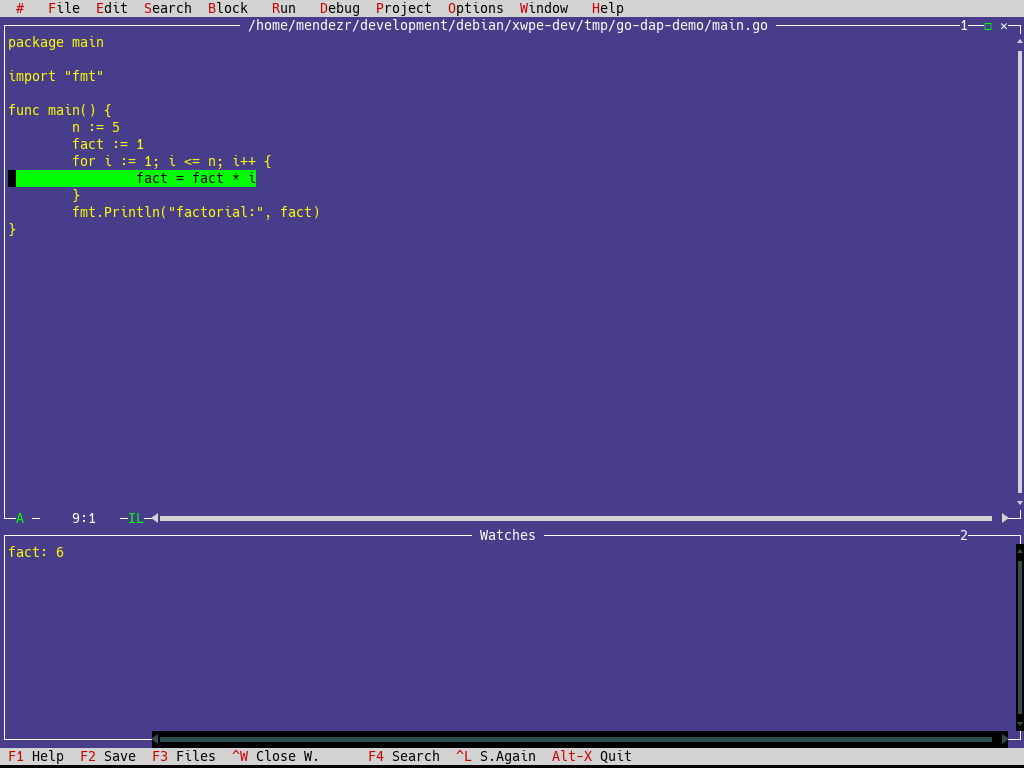
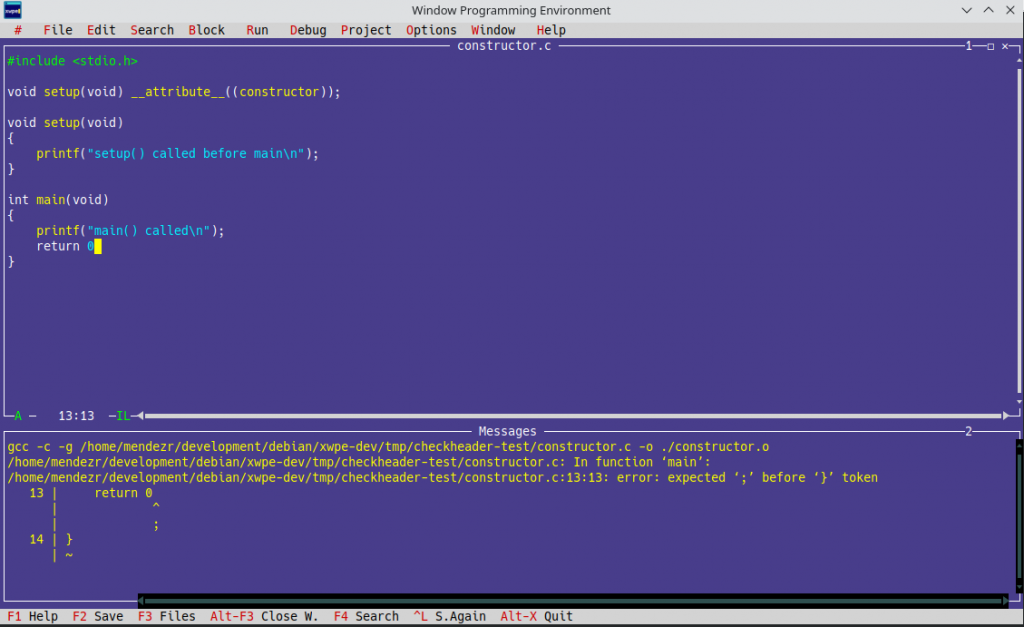
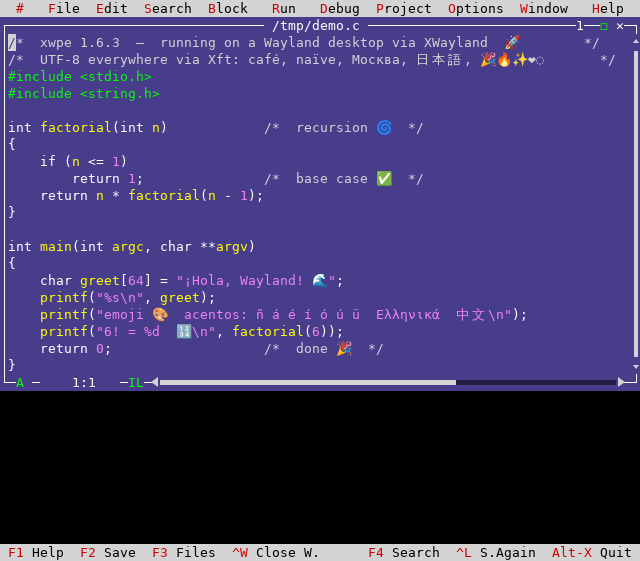


 Pero no te des por vencido/a, haz pruebas y actualiza frecuentemente tus clientes porque esta situación está evolucionando para bien.