
Des statistiques sans robots avec GoatCounter auto-hébergé sur NixOS
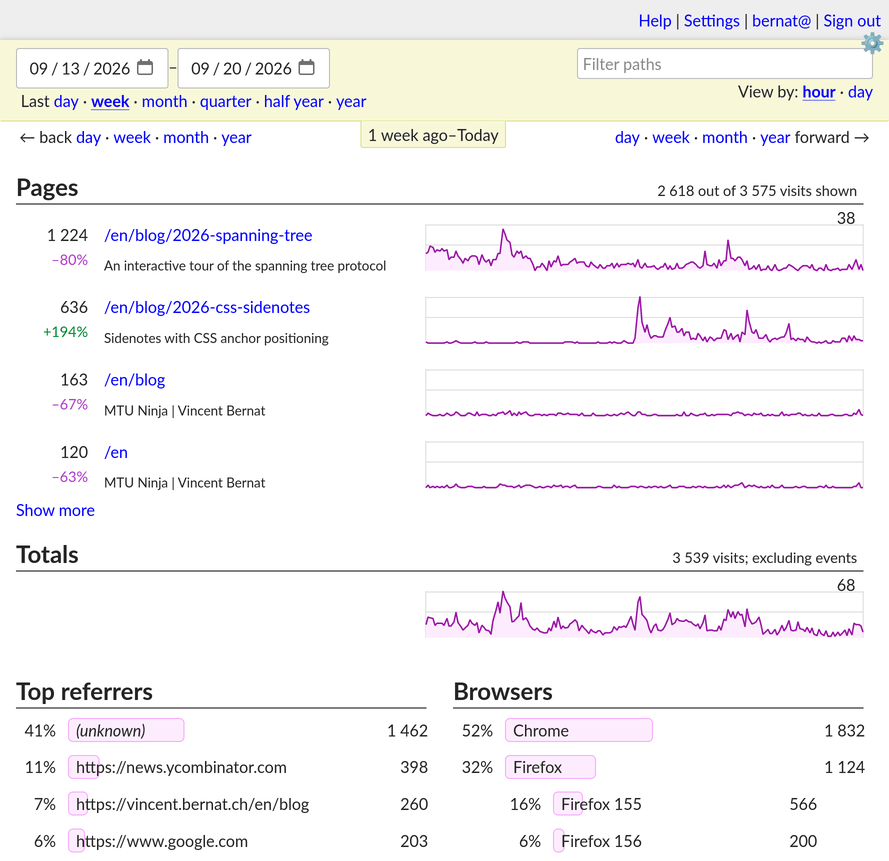
En 2016, j’ai retiré Google Analytics de ce blog pour ne pas me rendre complice de la plus grande machine à aspirer les données personnelles. À la place, j’analysais les journaux de mes serveurs1 avec GoAccess. Depuis quelques années, les statistiques ne veulent plus rien dire, malgré mes tentatives pour filtrer les robots : les robots pilleurs des IA gonflent le nombre de visiteurs à environ 2 000 par jour. J’ai fini par adopter GoatCounter, une plateforme libre de mesure d’audience, respectueuse de la vie privée. J’ai remplacé le client JavaScript pour filtrer les robots de façon plus agressive et ajouté une solution de repli en CSS. Pour gagner en fiabilité, j’ai écrit un proxy local, installé sur chacun des cinq serveurs web qui hébergent ce blog. La suite de cet article détaille comment ces éléments s’articulent et comment je déploie l’ensemble sur NixOS. ❄️
Pourquoi GoatCounter ?
GoatCounter ne collecte aucune donnée personnelle : au lieu de stocker l’adresse IP du lecteur ou de s’appuyer sur des cookies, il crée un identifiant de session valide 8 heures à partir de l’agent utilisateur et de l’adresse IP. Ses fonctionnalités sont modestes, mais suffisantes pour un blog. Pour un aperçu de l’interface, l’auteur de GoatCounter propose une instance publique pour son site. Une version en ligne permet de l’essayer avant de l’héberger soi-même. Avec un seul binaire et une base de données SQLite, GoatCounter est l’une des solutions auto-hébergées les plus légères. Parmi les alternatives respectueuses de la vie privée figurent, par ordre croissant de complexité, Umami, Plausible et Rybbit.
Client JavaScript sur mesure
GoatCounter fournit un petit client JavaScript : 2 189 octets une fois minifié et compressé avec gzip. Il embarque des fonctionnalités dont je ne me sers pas : un compteur de visites, le suivi des clics, divers réglages, etc. Je le remplace par cette fonction pour enregistrer une visite :
const count = ({ event, title } = {}) => {
  const params = new URLSearchParams({
    p: event || location.pathname,
    t: title || document.title,
    r: document.referrer,
    q: location.search,
    s: document.documentElement.clientWidth,
    e: !!event,
    rnd: Math.random().toString(36).slice(2, 7),
  });
  fetch(`/count?${params}`, { keepalive: true }).catch(() => {});
};
Pour filtrer les robots2, je vais plus loin en exigeant une interaction de l’utilisateur, une idée reprise de Bear Blog.
let sendHit = () => (sendHit = () => {}, count());
["touchmove", "mousemove", "keydown", "pointerdown"].forEach((eventName) =>
  document.addEventListener(eventName, sendHit, {
    once: true,
    passive: true,
  }),
);
Si un lecteur a désactivé JavaScript dans son navigateur, j’enregistre la visite
à l’aide d’une image CSS. La pseudo-classe :hover ne la charge qu’après une
interaction, une autre astuce piquée à Bear Blog. Environ 2 % de mes
visiteurs entrent dans cette catégorie3.
<!DOCTYPE html>
<html lang="en" class="nojs">
  <head>
    <script>
      // Le code JavaScript de ce blog requiert ES6
      if ("noModule" in HTMLScriptElement.prototype)
        document.documentElement.classList.remove("nojs");
    </script>
  </head>
  <body>
  <!-- ... -->
    <style>
      .nojs body:hover {
        border-width: 0;
        border-image: url('/count?p=/en/blog/2026-kpi-goodhart&t=Building...&r=NoJS&e=false');
      }
    </style>
  </body>
</html>
Là où GoAccess annonçait environ 2 000 visiteurs par jour, GoatCounter compte moins de 200 humains4. Je suppose que ces pilleurs privilégient le moindre effort : si le contenu est accessible sans obstacle, comme sur ce blog, ils ne vont pas lancer une usine à gaz qui déclencherait une page vue. Même les robots qui exécutent JavaScript, comme Googlebot avec son Chromium sans interface, n’interagissent pas avec la page et ne déclenchent jamais les événements que j’écoute. La « preuve d’humanité » par l’interaction que j’utilise me semble pouvoir durer5.
Proxy local
Cinq serveurs à travers le monde en Europe et en Amérique du
Nord servent le contenu de ce site, mais GoatCounter ne tourne que sur
l’un d’eux. Pour ne pas perdre la trace des visiteurs quand GoatCounter est
indisponible, j’exécute un proxy local qui écoute sur le même point de
terminaison /count. Sur chaque serveur, il conserve les visites en mémoire,
avec un tampon assez grand pour tenir plusieurs jours en cas d’indisponibilité.
Il les envoie par lots au serveur amont via le point de terminaison authentifié
/api/v0/count.
J’ai proposé le code du proxy dans la pull request #909. Le mainteneur de GoatCounter a refusé de maintenir cet amas de code pour un cas d’usage aussi niche. Développant moi aussi des logiciels libres, j’adopte souvent la même position pour mes propres projets : l’effort ponctuel d’un contributeur peut se transformer en engagement sur le long terme pour le mainteneur.
J’expose le point de terminaison du proxy sur le domaine de ce site pour échapper aux bloqueurs de publicité. Cela donne l’impression que je ne respecte pas le choix du lecteur, mais comme GoatCounter respecte la vie privée, je trouve cela acceptable.
location = /count {
  access_log off;
  proxy_pass http://127.0.0.3:8087/count;
  proxy_pass_request_headers off;
  proxy_set_header Accept-Language $http_accept_language;
  proxy_set_header User-Agent $http_user_agent;
  proxy_set_header X-Real-Ip $remote_addr;
}
Déploiement sur NixOS
Mes serveurs web tournent sous NixOS, une distribution Linux déclarative avec une gestion de configuration intégrée. Je gère ce petit troupeau avec Colmena, un outil de déploiement sans état pour NixOS. Ma configuration est disponible sur GitHub.
Déployer des applications dans des conteneurs
Pour une meilleure isolation, chaque application tourne dans un conteneur léger
et éphémère, propulsé par systemd-nspawn. Chaque conteneur exécute une
instance allégée de NixOS. Un module encapsule les options containers de
NixOS pour éviter de répéter les mêmes options pour chaque
application6. Les conteneurs partagent la pile réseau de l’hôte :
l’isolation supplémentaire ne vaut pas la complexité accrue. Pour les alléger,
je désactive aussi quelques services non essentiels.
{ config, lib, ... }:
let
  cfg = config.luffy.containers;
in
{
  # Réglages configurables pour notre module
  options.luffy.containers = lib.mkOption {
    default = { };
    description = "Ephemeral containers sharing the host network.";
    type = lib.types.attrsOf (lib.types.submodule {
      options = {
        config = lib.mkOption {
          type = lib.types.deferredModule;
          default = { };
          description = "NixOS configuration of the container.";
        };
      };
    });
  };

  # Traduit nos options en conteneurs NixOS
  config = {
    containers = lib.mapAttrs
      (name: container: {
        ephemeral = true;
        autoStart = true;
        privateNetwork = false;
        extraFlags = [ "--resolv-conf=replace-host" ];
        config = {
          imports = [ container.config ];
          networking.firewall.enable = false;
          system.stateVersion = config.system.stateVersion;
          systemd.services = {
            console-getty.enable = false;
            systemd-logind.enable = false;
            systemd-oomd.enable = false;
          };
        };
      })
      cfg;
  };
}
Pour configurer une instance GoatCounter tournant dans un conteneur et écoutant
sur 127.0.0.4:8088, nous importons le module7 et déclarons le
conteneur dans l’ensemble d’attributs config.luffy.containers :
{ pkgs, config, ... }: {
  imports = [ ./modules/container.nix ];
  config.luffy.containers.goatcounter = {
    config = {
      services.goatcounter = {
        enable = true;
        address = "127.0.0.4";
        port = 8088;
        proxy = true;
      };
    };
  };
}
Comme les conteneurs sont éphémères, il faut conserver les données persistantes
dans des répertoires de l’hôte. Nous ajoutons une option mounts et demandons
aux conteneurs de NixOS d’exposer les répertoires ainsi configurés via l’option
bindMounts.
{ config, lib, ... }:
let
  cfg = config.luffy.containers;
in
{
  options.luffy.containers = lib.mkOption {
    type = lib.types.attrsOf (lib.types.submodule {
      options = {
        mounts = lib.mkOption {
          type = lib.types.listOf lib.types.str;
          default = [ ];
          description = "Host directories mounted read-write at the same place.";
        };
      };
    });
  };

  config = {
    containers = lib.mapAttrs
      (name: container: {
        bindMounts =
          lib.genAttrs container.mounts (path: { hostPath = path; isReadOnly = false; });
      })
      cfg;
  };
}
Par exemple, pour conserver la base de données de GoatCounter dans le répertoire
/var/db/goatcounter de l’hôte, nous ajoutons ce répertoire à l’option mounts
et modifions la définition du service pour indiquer à GoatCounter où trouver la
base de données.
{ config, ... }:
let
  databaseDirectory = "/var/db/goatcounter";
in {
  config.luffy.containers.goatcounter = {
    mounts = [ databaseDirectory ];
    config = {
      services.goatcounter = {
        extraArgs = [ "-db=sqlite+${databaseDirectory}/db.sqlite" ];
      };
    };
  };
}
Un conteneur peut aussi avoir besoin de secrets. Colmena peut envoyer des
secrets sans les stocker dans /nix. Nous ajoutons une option
keys à nos conteneurs. Elle prend un ensemble d’attributs associant le nom de
chaque secret à la commande qui le fournit. Ensuite, le module déclare les
secrets requis à Colmena dans l’option deployment.keys, fait dépendre le
conteneur de la présence des secrets, puis les attache au conteneur.
{ config, lib, ... }:
let
  cfg = config.luffy.containers;
in
{
  options.luffy.containers = lib.mkOption {
    type = lib.types.attrsOf (lib.types.submodule {
      options = {
        keys = lib.mkOption {
          type = lib.types.attrsOf (lib.types.listOf lib.types.str);
          default = { };
          description = "Secrets, as a command to run locally. They are mounted in /etc.";
        };
      };
    });
  };

  config = {
    # Colmena place chaque secret dans `/var/keys` et le rend accessible
    # au groupe "keys".
    deployment.keys = lib.concatMapAttrs
      (_: container: lib.mapAttrs
        (_: keyCommand: {
          inherit keyCommand;
          group = "keys";
          permissions = "0640";
          destDir = "/var/keys";
        })
        container.keys)
      cfg;

    # Le conteneur ne peut démarrer que si les secrets requis sont disponibles.
    systemd.services = lib.mapAttrs'
      (name: container:
        let
          units = map (key: "${key}-key.service") (lib.attrNames container.keys);
        in
        lib.nameValuePair "container@${name}" {
          requires = units;
          after = units;
        })
      cfg;

    # Attache chaque secret dans le conteneur.
    containers = lib.mapAttrs
      (name: container: {
        bindMounts = lib.mapAttrs'
          (key: _: lib.nameValuePair "/etc/${key}" {
            hostPath = "/var/keys/${key}";
            isReadOnly = true;
          })
          container.keys;
      })
      cfg;
  };
}
Par exemple, GoatCounter a besoin d’identifiants pour télécharger la base de
données GeoIP. Je fournis une commande locale pour récupérer le secret depuis
mon gestionnaire de mots de passe et je l’expose dans le conteneur via le
fichier d’environnement /etc/goatcounter.env.
{ pkgs, config, ... }:
let
  keyCommand = variable: [
    "${pkgs.runtimeShell}"
    "-c"
    "pass show personal/nixops/secrets | grep '^${variable}='"
  ];
in {
  config.luffy.containers.goatcounter = {
    keys."goatcounter.env" = keyCommand "GOATCOUNTER_GEODB";
    config = {
      systemd.services.goatcounter.serviceConfig = {
        EnvironmentFile = "/etc/goatcounter.env";
        SupplementaryGroups = [ "keys" ];
      };
    };
  };
}
Serveur GoatCounter
Nixpkgs fournit déjà un paquet pour GoatCounter. En surchargeant les attributs
src et vendorHash, je réutilise sa définition pour ma version personnalisée
avec le proxy :
{ goatcounter, fetchFromGitHub }:
goatcounter.overrideAttrs (_: {
  src = fetchFromGitHub {
    owner = "vincentbernat";
    repo = "goatcounter";
    rev = "feature/proxy";
    hash = "sha256-dJRlQlFu3tjcEgabT1LEbyFrasJlhmYu4L/T7EkoNcY=";
  };
  vendorHash = "sha256-c9Q5OrbZR+q6pD3SgPPWe8JUzcZco1AVUKGaV61k5DE=";
})
J’ai écrit un module NixOS pour encapsuler GoatCounter : la
définition du conteneur, celle du service et les secrets. Le module accepte les
options suivantes : package, serve.enable, serve.listenAddress,
serve.port et serve.databaseFile. J’ai déjà détaillé la configuration du
conteneur dans la section précédente. Finalement, j’ai choisi de ne pas
réutiliser le module GoatCounter de NixOS : il est plutôt simple et le réécrire
permet de me protéger de changements futurs inattendus.
{ config, pkgs, lib, ... }:
let
  cfg = config.luffy.goatcounter;
  databaseDirectory = builtins.dirOf cfg.serve.databaseFile;
  chown = "${pkgs.coreutils}/bin/chown -R";
in {
  config.luffy.containers.goatcounter = {
    config.systemd.services.goatcounter = {
      description = "GoatCounter Web Analytics";
      wantedBy = [ "multi-user.target" ];
      serviceConfig = {
        EnvironmentFile = "/etc/goatcounter.env";
        SupplementaryGroups = [ "keys" ];
        DynamicUser = true;
        Restart = "always";
        ExecStart = lib.escapeShellArgs [
          (lib.getExe cfg.package)
          "serve"
          "-listen=${cfg.serve.listenAddress}:${toString cfg.serve.port}"
          "-tls=none"
          "-db=sqlite+${cfg.serve.databaseFile}"
          "-automigrate"
        ];
        # Donne la base de données à l'utilisateur dynamique "goatcounter".
        ExecStartPre = "+${chown} goatcounter:goatcounter ${databaseDirectory}";
        ReadWritePaths = databaseDirectory;
      };
    };
  };
}
Le bout de code suivant configure GoatCounter pour écouter sur
127.0.0.4:8088 :
{
  luffy.goatcounter = {
    serve = {
      enable = true;
      listenAddress = "127.0.0.4";
      port = 8088;
    };
  };
}
La dernière étape consiste à configurer nginx pour exposer GoatCounter sur
Internet. Je désactive le point de terminaison /count, car sa fonction est
assurée par le proxy local.
{ config, ... }:
let
  cfg = config.luffy.goatcounter.serve;
in
{
  services.nginx.virtualHosts."goatcounter.luffy.cx" = {
    forceSSL = true;
    locations = {
      "/" = {
        proxyPass = "http://${cfg.listenAddress}:${toString cfg.port}";
      };
      "= /count".extraConfig = ''
        return 404;
      '';
    };
  };
}
Proxy GoatCounter
Le même module NixOS configure le proxy local, avec les
options suivantes : proxy.enable, proxy.listenAddress, proxy.port et
proxy.site (le site qui reçoit les lots de pages vues). Le proxy local n’a
aucune donnée persistante, mais il a besoin de la clé d’API pour s’authentifier
auprès de l’instance principale de GoatCounter : son conteneur utilise l’option
keys, mais pas l’option mounts.
{ config, pkgs, lib, ... }:
let
  cfg = config.luffy.goatcounter;
  keyCommand = _: [ "…" ];
in
{
  config.luffy.containers.goatcounter-proxy = {
    keys."goatcounter-proxy.env" = keyCommand "GOATCOUNTER_API_KEY";
    config.systemd.services.goatcounter = {
      description = "GoatCounter Proxy.";
      wantedBy = [ "multi-user.target" ];
      serviceConfig = {
        EnvironmentFile = "/etc/goatcounter-proxy.env";
        SupplementaryGroups = [ "keys" ];
        DynamicUser = true;
        Restart = "always";
        ExecStart = lib.escapeShellArgs [
          (lib.getExe cfg.package)
          "proxy"
          "-site=${cfg.proxy.site}"
          "-listen=${cfg.proxy.listenAddress}:${toString cfg.proxy.port}"
          "-ratelimit=10/1"  # 10 requêtes par seconde par IP
        ];
      };
    };
  };
}
Sur chaque serveur, j’active le proxy local avec le bout de code suivant. La
configuration nginx présentée plus haut expose le point de terminaison /count
sous le même domaine que mon blog.
{
  luffy.goatcounter = {
    proxy = {
      enable = true;
      site = "goatcounter.luffy.cx";
      listenAddress = "127.0.0.3";
      port = 8087;
    };
  };
}
Sauvegarde de la base de données SQLite avec Litestream
Litestream est un outil de réplication en continu pour les bases de données
SQLite. Il compresse les changements placés dans le journal d’écriture
anticipée (WAL) situé à côté de la base de données et les envoie vers une
destination distante. J’encapsule sa configuration dans un module
NixOS, qui prend un ensemble d’attributs databases associant
un nom au chemin de la base de données à sauvegarder.
Litestream tourne lui aussi dans un conteneur. Je monte les bases de données à répliquer, ainsi que les secrets pour pousser les sauvegardes vers une storage box de Hetzner via SFTP :
{ config, pkgs, lib, ... }:
let
  cfg = config.luffy.litestream;
  databaseDirs = lib.unique (map builtins.dirOf (builtins.attrValues cfg.databases));
in
{
  config = lib.mkIf (cfg.databases != { }) {
    luffy.containers.litestream = {
      mounts = databaseDirs;
      keys."litestream.env" = [
        "${pkgs.runtimeShell}"
        "-c"
        "pass show personal/nixops/secrets | grep '^SQLITE_BACKUP_'"
      ];
    };
  };
}
Dans le conteneur, je configure Litestream à travers les options
services.litestream de NixOS :
- des instantanés complets chaque jour, conservés 15 jours ;
- trois niveaux de compactage pour les transactions : 5 minutes, 30 minutes et 3 heures ;
- la reprise automatique8 ;
- un réplica stocké dans un répertoire portant le nom de l’hôte ;
- des identifiants lus depuis
/etc/litestream.envet exposés par expansion de variables.
{ config, pkgs, lib, ... }:
let
  cfg = config.luffy.litestream;
in
{
  config.luffy.containers.litestream = {
    config = {
      # Les bases de données appartiennent à des utilisateurs dynamiques, dont
      # l'UID n'est pas connu ici : Litestream tourne donc en root.
      systemd.services.litestream.serviceConfig = {
        User = lib.mkForce "root";
        Group = lib.mkForce "root";
      };
      # Utilise le service NixOS.
      services.litestream = {
        enable = true;
        environmentFile = "/etc/litestream.env";
        settings = {
          auto-recover = true;
          snapshot = {
            interval = "24h";
            retention = "360h";
          };
          levels = [
            { interval = "5m"; }
            { interval = "30m"; }
            { interval = "3h"; }
          ];
          dbs = lib.mapAttrsToList
            (name: path: {
              inherit path;
              replica = {
                type = "sftp";
                host = "\${SQLITE_BACKUP_HOST}";
                user = "\${SQLITE_BACKUP_USER}";
                password = "\${SQLITE_BACKUP_PASSWORD}";
                host-key = "\${SQLITE_BACKUP_HOSTKEY}";
                path = "${config.networking.hostName}/${name}";
              };
            })
            cfg.databases;
        };
      };
    };
  };
}
Pour sauvegarder la base de données de GoatCounter, je déclare un attribut
goatcounter dans luffy.litestream.databases avec pour valeur le chemin de la
base de données :
{ config, ... }:
let
  cfg = config.luffy.goatcounter.serve;
in
{
  luffy.litestream.databases.goatcounter = cfg.databaseFile;
}
Sur le serveur SFTP, nous pouvons inspecter le travail de Litestream, avec les transactions compactées et les instantanés complets :
❯ ls web02/goatcounter/ltx
web02/goatcounter/ltx/0
web02/goatcounter/ltx/1
web02/goatcounter/ltx/2
web02/goatcounter/ltx/3
web02/goatcounter/ltx/9
❯ ls -lh web02/goatcounter/ltx/1
29.1K Sep  5 01:25 0000000000003f2a-0000000000003f2b.ltx
72.4K Sep  5 02:03 0000000000003f2c-0000000000003f2d.ltx
63.3K Sep  5 02:24 0000000000003f2e-0000000000003f2f.ltx
[…]
❯ ls -lh web02/goatcounter/ltx/9
 8.5M Sep  5 02:00 0000000000000001-0000000000003f2b.ltx
 8.5M Sep  6 02:03 0000000000000001-0000000000004008.ltx
 8.6M Sep  7 02:03 0000000000000001-00000000000043a8.ltx
[…]
Nous pouvons restaurer la base de données depuis la sauvegarde avec quelques
commandes shell. D’abord, nous arrêtons les conteneurs. Ensuite, nous mettons de
côté la base de données endommagée, invoquons litestream restore depuis le bon
environnement et redémarrons les conteneurs9.
# systemctl stop container@goatcounter container@litestream
# mv /var/db/goatcounter/db.sqlite{,.old}
# ( . /etc/nixos-containers/litestream.conf ;
>   set -a ; . /var/keys/litestream.env ; set +a ;
>   $SYSTEM_PATH/sw/bin/litestream \
>     restore -config $SYSTEM_PATH/etc/litestream.yml /var/db/goatcounter/db.sqlite)
# ls -lh /var/db/goatcounter/db.sqlite
-rw-r--r-- 1 root root 20M Sep 20 07:33 /var/db/goatcounter/db.sqlite
# systemctl start container@goatcounter container@litestream
Dix ans après avoir retiré Google Analytics, les statistiques en JavaScript sont de retour sur ce blog, mais sans stocker de cookies ni d’adresses IP, et sans se reposer sur un tiers. J’écris d’abord pour moi, notamment parce que cela me permet de creuser un sujet et de m’y référer des années plus tard. Cependant, en savoir un peu plus sur mes lecteurs humains est un bonus appréciable, y compris sur ceux qui n’activent pas JavaScript. 🐐
-
Nginx brouille les adresses IP avant de les enregistrer, grâce au module
ipscrub. ↩ -
GoatCounter filtre déjà certains robots grâce à leur agent utilisateur ou à leur adresse IP. Mais les robots pilleurs mentent sur leur agent utilisateur et se cachent derrière des proxys résidentiels. ↩
-
Sans JavaScript, impossible d’envoyer la véritable origine. J’indique « NoJS » à la place. ↩
-
Il me manque les humains lisant le flux RSS. Je ne suis pas à l’aise avec l’idée d’ajouter un pixel transparent, et les robots le chargeraient sans doute, ce qui fausserait les statistiques. Je me passe de compter ces lecteurs. ↩
-
En février 2025, j’ai testé une autre approche reposant uniquement sur CSS sans détecter d’interaction : chaque page chargeait une image vide comme arrière-plan. Sur un mois, elle a enregistré jusqu’à dix fois moins de pages vues que les journaux de nginx, même après avoir retiré les robots qui s’identifiaient comme tels. Par rapport à cette expérience, 18 mois plus tard, GoatCounter compte environ trois fois moins de vues. Comme les périodes diffèrent, la comparaison n’est pas rigoureuse, mais elle donne une idée de l’efficacité de cette preuve d’humanité. ↩
-
Un module NixOS est une fonction qui reçoit la configuration de l’ensemble du système dans
configet renvoie trois attributs :importsliste d’autres modules à importer ;optionsdéclare les réglages configurables par l’utilisateur ;configattribue des valeurs aux options déclarées par n’importe quel module, commecontainersde NixOS.
Si un module ne déclare aucune option, il est possible de renvoyer directement les attributs contenus dans
config. Si un module n’a besoin d’aucun argument, vous pouvez le définir comme un simple ensemble d’attributs. ↩ -
La plupart du temps, un import explicite est inutile. NixOS importe automatiquement les modules livrés avec Nixpkgs. Pour mes propres modules, un peu de code les importe aussi automatiquement. ↩
-
Litestream déconseille l’option
auto-recover, car elle peut entraîner une perte de données. Mais je ne surveille pas assez attentivement mes serveurs et je préfère des sauvegardes toujours fonctionnelles à un faible risque de perdre les derniers enregistrements. ↩ -
Chez moi, le processus est lent : environ 20 minutes pour une base de données de 20 Mio. Vous pouvez tester en restaurant vers une copie avec l’option
-o, mais il faut tout de même arrêter le conteneur Litestream. ↩
20 September, 2026 07:44PM by Vincent Bernat




 Le travail en profondeur (deep work en anglais) est l’énorme oublié de l’activité sur site. Étant donné l’organisation actuelle des bureaux, il n’est aujourd’hui possible (quasiment) qu’en télétravail.
 Pour rappel, le travail en profondeur s’incarne dans des plages de temps de travail ininterrompues, de 1h à 4h. Vous commencez à voir le problème.
 Impossible de se concentrer dans un open space. Les discussions au téléphone incessantes vous en empêchent. Des réunions démarrent tous les demi-heures, parfois tous les quarts d’heure, et viennent briser votre concentration.
 Entre les deux, des collègues discutent de différents projets, mais aussi de la pluie et du beau temps sous votre nez, vous interpellent directement s’ils ont une question, perturbant les calculs complexes que vous étiez laborieusement en train d’essayer de mener à leur terme.
 À midi, c’est le grand départ, des groupes se joignent, il faut courir pour manger avec untel ou unetelle, ou on vient vous chercher sans vergogne à votre bureau, sans se soucier du rythme de travail qui est nécessaire pour mener à bien votre étude en cours.
 Bien sûr, tous les métiers n’ont peut-être pas besoin de travail en profondeur. Les métiers réactifs, ou on se met en avant en réagissant à tout ce qui se passe dans l’entreprise (et souvent à rien), sont ceux qui permettent d’être le plus visible et donc de se mettre en avant. Mais beaucoup le nécessitent. Le développement d’applications, la conception d’architecture complexe, et sûrement beaucoup d’autres demandent un travail en profondeur pour être mené à bien et dans les meilleures conditions.
 Et vous ? Comment gérez-vous vos plages de travail en profondeur ? Vous y arrivez sur site ou vous attendez vos jours de télétravail ? Dites moi tout en commentaires

 Je suis architecte infrastructure cloud (AWS et Azure) senior freelance, adepte du télétravail et du travail en profondeur, et conçois les infrastructures dont vous avez besoin pour faire tourner les services IT de vos entreprises. Disponible pour une nouvelle mission dès mi-janvier 2026. N’hésitez pas à me contacter si je peux vous aider dans vos projets.









 Mon rapport mensuel couvre une grande partie de mes contributions au logiciel libre. Je l’écris pour





 Les trolls, une activité prisée des Libristes


 L’octocat, mascotte de Github

 Windows, qui reste le logiciel privateur par excellence, même si d’autres l’ont depuis rejoint
 L’uniforme évoque l’armée, ici l’armée des clones


 FreeBSD, principal projet des BSD sous licence BSD
 Issues, le suivi de bug propriétaire de Github
 Debian, l’un des principaux projets du Logiciel Libre avec autour de 1000 contributeurs officiels


 Le « lion » devant la cheminée
 Premiers pas plutôt festifs le vendredi soir avec le SysAdmin Day dans un bar à Manhattan puis direction Brooklyn pour une Debian Party organisée par
 C’est donc le dimanche 1er août que commence la DebConf avec des présentations orientées grand public pour cette première journée appelée le “Debian Day”. Un
 Deuxième jour, on a le droit à un
 Troisième jour et l’on débute par un
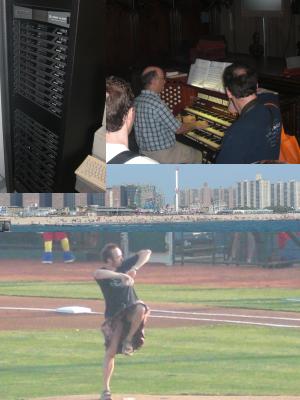 Le quatrième jour, c’est le Day Trip. Il s’agit classiquement d’une journée consacrée à des activités touristiques extérieures. Nous avons été visiter l’église Trinity Church à Manhattan où le drame du 11 septembre 2001 a mis un superbe orgue hors d’usage, remplacé temporairement par un orgue électronique “Powered by Linux”… qui a finalement été conservé en raison de sa qualité. Keith Packard, l’un des gourous de X.org employé chez Intel, a joué quelques minutes sur cet orgue. Ensuite, direction la plage de Coney Island. Puis un match de baseball où Stefano Zacchiroli lancera la première balle du match.
 Cinquième jour, on reprend avec un
 Sixième jour, on débute par
 Septième et dernier jour, encore de nombreuses présentations. J’ai notamment assisté à celle de Philippe Kern, membre de la Release Team, qui


